
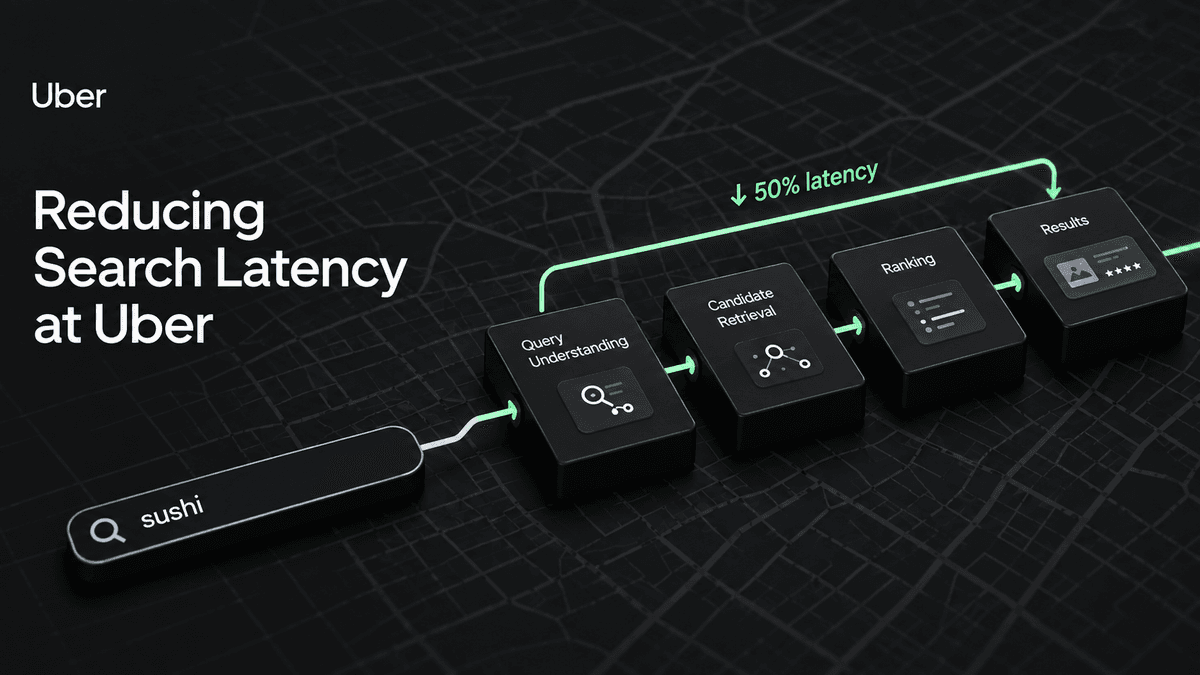
Uber Eats Otimiza Latência de Busca com Inovações em Pipeline
Aprofundamento CEVIU
Aprofundamento
A equipe do Uber Eats detalhou uma otimização profunda em seu pipeline de busca, resultando em uma redução de 50% na latência de ponta a ponta. A abordagem foi holística, focando em métricas como o tempo de conclusão "Above-the-Fold" (ATF), que mede desde a submissão da consulta até a renderização completa da primeira tela de resultados. Melhorias arquitetônicas incluíram a eliminação de caminhos de recuperação de baixo valor, a segregação da hidratação de dados para ranqueamento e apresentação, além de paginação e renderização concorrente para a interface do usuário. No lado da infraestrutura, houve ajuste fino em vários pontos, como o uso de request hedging para lidar com latência de cauda, embeddings mais compactos para reduzir latência de banco de dados e correção de gargalos de conexão na service mesh.
Um dos pontos mais inovadores foi o uso de um laço de IA agentic para identificar e corrigir problemas de latência. Esse sistema autônomo conseguia puxar perfis de latência de produção, identificar gargalos, propor correções de código, abrir pull requests e validar as melhorias com benchmarks, garantindo que as otimizações não degradassem a qualidade da busca. Olhando para o futuro, o Uber Eats planeja implementar microbatching, busca e hidratação em nível de produto (em vez de item) e Zero-Pass Ranking (ZPR), além de streaming de fragmentos HTML para aprimorar ainda mais a experiência de busca.
O que mudou
A otimização de infraestrutura da Uber continua sendo uma área de investimento estratégico. Enquanto a cobertura do CEVIU em 30 de setembro de 2026, com o artigo "Uber Fortalece Service Mesh Contra 'Tempestades de Retries'", focou nos mecanismos de error ownership para resiliência na service mesh, a notícia atual sobre o Uber Eats mostra uma evolução na atenção aos detalhes operacionais. Agora, a empresa aborda especificamente os gargalos de conexão dentro da service mesh, como o limite fixo de conexões concorrentes. A solução de abrir múltiplas conexões paralelas para serviços de alto tráfego demonstra um refinamento contínuo das práticas de engenharia de plataforma da Uber, indo além da gestão de retries para otimizar o fluxo de requisições e a latência.
Por que isso importa
Para engenheiros de plataforma e equipes de DevOps, esta otimização do Uber Eats é um estudo de caso valioso sobre como uma abordagem full-stack pode gerar resultados expressivos. A mudança de foco da latência de backend para a métrica ATF destaca a importância de medir o impacto real na experiência do usuário, englobando todo o percurso da requisição. Além disso, o uso de IA agentic para encontrar e corrigir problemas de latência aponta para uma tendência futura de automação inteligente na engenharia de sistemas. Isso não só melhora a satisfação do cliente e a taxa de conversão, mas também libera tempo de engenheiros para tarefas mais complexas, otimizando recursos e acelerando o ciclo de inovação.
Linha do tempo
Pinterest otimiza dados de sequência do usuário com 'configuration-as-code'.
GitHub acelera busca de código otimizando o <em>case-folding</em>.
Tubular Labs otimiza pipeline de 70TB com Apache Iceberg e S3.
Google revoluciona busca em IA com <em>Retrieve-for-Train</em>.
Uber fortalece <em>Service Mesh</em> contra 'tempestades de retries'.
Uber Eats otimiza latência de busca em 50% com inovações no pipeline.
Estudo demonstra otimização de pipelines de Agentes de IA, reduzindo latência em AWS Bedrock.
Perguntas frequentes
O que significa a latência "Above-the-Fold" (ATF) e por que ela é importante?
Latência ATF é o tempo desde o envio de uma consulta até a renderização completa da primeira tela de resultados visível para o usuário. Ela é crucial porque reflete diretamente a experiência do usuário, impactando a conversão e o engajamento de forma mais precisa que apenas a latência de API do backend.
Como o Uber Eats utilizou IA para otimizar a latência?
O Uber Eats empregou um laço de IA agentic, que de forma autônoma identificava gargalos de latência em produção, sugeria e aplicava correções de código, e validava as melhorias com benchmarks. Essa abordagem automatizada permitiu identificar e resolver problemas rapidamente, especialmente aqueles que são pequenos individualmente mas que se somam a um impacto significativo.
O que são "embeddings compactos" e como eles ajudaram a reduzir a latência?
Embeddings são representações numéricas usadas por modelos de Machine Learning, especialmente em busca, para representar itens ou consultas. O Uber Eats reduziu o tamanho desses embeddings diminuindo a precisão dos pontos flutuantes e usando codificação de inteiros de comprimento variável, o que cortou o tamanho dos embeddings em 46% e diminuiu pela metade a latência de consulta ao banco de dados.
Quais são as futuras otimizações planejadas para o pipeline de busca do Uber Eats?
Os planos futuros incluem a implementação de microbatching para permitir o processamento paralelo das etapas do pipeline, a mudança da busca e hidratação para o nível de produto (em vez de item) para reduzir o volume de dados, e o uso de Zero-Pass Ranking (ZPR) para filtrar candidatos mais cedo, além de streaming de fragmentos HTML para renderização mais rápida da interface do usuário.
Fontes
- uber.comfonte original
- Categoria
- CEVIU DevOps
- Publicado
- 05 de outubro de 2026
- Editoria
- CEVIU DevOps