
Como operar produção sem armazenar logs, com K3s e Prometheus
Aprofundamento CEVIU
Aprofundamento
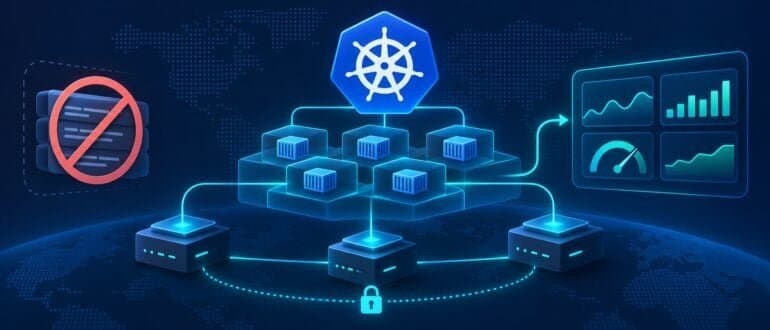
O autor opera uma plataforma com mais de 15 microservices em K3s, rodando em VPS espalhadas por locais diferentes e ligadas por uma rede privada WireGuard. Novos nós entram no cluster via Ansible, a partir de uma VPS limpa, em minutos. O ponto fora da curva é uma restrição de projeto: não existe coleta, encaminhamento nem arquivo centralizado de logs de aplicação. A observabilidade não pode virar meio de coletar informação sobre usuários.
Na prática, os nós enviam só métricas com rótulos técnicos (carga, latência, profundidade de fila, taxa de erro). A regra vale na ingestão: cada scrape job de aplicação tem uma lista curta de nomes de rótulo permitidos, e o que sair dela é removido antes de entrar no armazenamento. O __name__ precisa estar na lista, porque nessa etapa de relabeling o nome da métrica também é um rótulo. Há limites: o relabeling acontece depois do scrape, então o Prometheus ainda recebe o dado indevido, e a allowlist não valida valores. Por isso o code review exige que o rótulo de rota seja um template (como /users/:id) e não o caminho cru. Os alertas saem das mesmas séries, por sintomas visíveis ao usuário.
Para depurar, o autor sobe o LOG_LEVEL de um deployment, reproduz o problema, acompanha com kubectl logs -f e reverte. A saída dos containers continua capturada localmente pelo runtime, sujeita à rotação do nó, e o journald usa armazenamento volátil. Ou seja, há linhas de log, só não há sistema central que as retenha. Os custos admitidos: é preciso antecipar as perguntas, o verbose deve ser temporário, e o modelo não atende quem precisa de trilha de auditoria imutável.
Por que isso importa
Para quem opera plataforma, o texto funciona como exercício de projeto, não como receita universal. Se a pressão do seu time é minimização de dados ou custo de armazenar e indexar logs, vale avaliar quanto do troubleshooting já cabe em métricas bem desenhadas. Se há auditoria formal, a leitura é outra: o próprio autor diz que aí se constrói um pipeline de auditoria separado. O ponto mais prático é a disciplina: allowlist de rótulos na ingestão e revisão de cardinalidade e de rotas no code review.
Linha do tempo
CEVIU publica comparação de armazenamento de longo prazo compatível com Prometheus.
CEVIU noticia observabilidade no Kubernetes que integra métricas, logs, traces e profiling.
Texto descreve operação de K3s com Prometheus e sem armazenamento centralizado de logs.
Perguntas frequentes
É possível operar produção sem armazenar logs centralizados?
Segundo o autor, sim, numa plataforma K3s com mais de 15 microservices. Os alertas e a análise de incidentes saem de métricas do Prometheus com rótulos técnicos. Quando isso não basta, ele ativa logging verbose temporário em um serviço.
Como o Prometheus impede que dados de usuário sejam armazenados?
Cada scrape job de aplicação tem uma lista de rótulos permitidos no metric relabeling. Rótulos fora dela são descartados antes de entrar no armazenamento. O Prometheus ainda recebe o dado no scrape, então a instrumentação da aplicação também precisa evitar expor informação sensível.
Como depurar um problema sem um arquivo de logs?
O autor muda a variável LOG_LEVEL de um deployment, reproduz o erro e acompanha a saída com kubectl logs -f. Depois reverte a mudança. O verbose precisa continuar temporário, para não acumular o que a arquitetura quer evitar reter.
Esse modelo serve para ambientes com auditoria?
Não. O texto afirma que equipes com auditorias de compliance e necessidade de trilha imutável devem construir um pipeline de auditoria, não adotar essa arquitetura. Outro custo é que, sem arquivo de logs, perguntas não antecipadas ficam sem resposta.
Fontes
- cloudnativenow.comfonte original
- Categoria
- CEVIU DevOps
- Publicado
- 06 de novembro de 2026
- Editoria
- CEVIU DevOps