
OpenAI Otimiza Cache de Prompts para Família GPT-6 com Descontos e Novas Ferramentas
Aprofundamento CEVIU
Aprofundamento
A otimização no cache de prompts para a família GPT-6 da OpenAI é um passo importante para a engenharia de plataformas e a operação de sistemas de IA em escala. Descontos de até 90% em tokens de entrada cacheados, válidos por 30 minutos, significam uma redução drástica nos custos operacionais para aplicações que dependem de interações iterativas com os modelos. Isso é fundamental para manter a sustentabilidade financeira de agentes persistentes, que, conforme destacado pela OpenAI, trabalham por horas em tarefas complexas, como refatorar código ou produzir documentação.
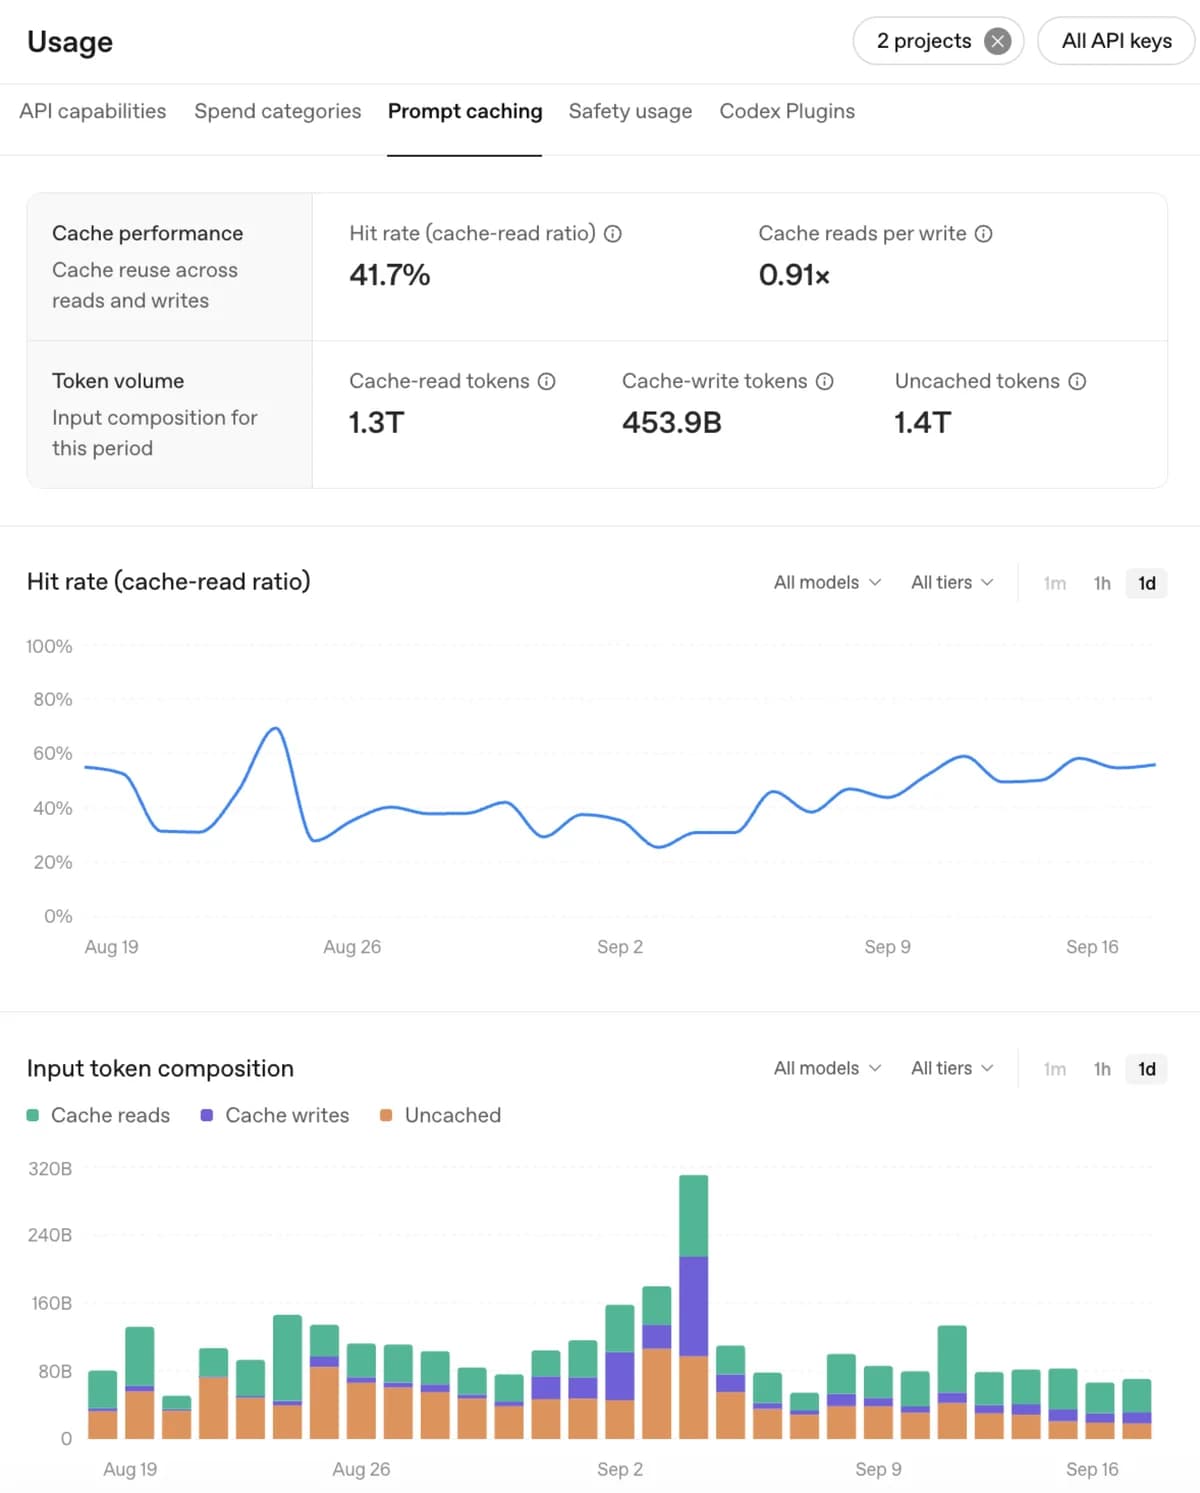
A disponibilidade de um Prompt Caching Dashboard e ferramentas de diagnóstico transforma a observabilidade. Plataformas podem monitorar as taxas de acerto do cache, identificar gargalos e investigar perdas de cache inesperadas, analisando mudanças em modelos, ferramentas ou configurações. Para os engenheiros de confiabilidade de sistemas, a capacidade de pré-aquecer o cache para reduzir a latência e de ajustar o esforço de raciocínio da IA sem invalidar o cache são recursos poderosos, permitindo otimizar o desempenho e a experiência do usuário sem comprometer a eficiência.
O que mudou
A cobertura anterior do CEVIU, de 23 de setembro de 2026, já antecipava que a OpenAI otimizaria o cache de prompts para o GPT-6, mencionando melhorias de desempenho, taxas de acerto elevadas e descontos para prefixos compartilhados. A notícia atual concretiza e aprofunda esses anúncios, detalhando o lançamento oficial do sistema aprimorado e, principalmente, a introdução de ferramentas práticas. Agora, desenvolvedores e engenheiros de plataforma contam com um Prompt Caching Dashboard e ferramentas de diagnóstico, que antes eram apenas parte da promessa, para gerenciar ativamente e otimizar o uso do cache. A opção de pré-aquecer o cache e ajustar o esforço de raciocínio sem invalidar o cache também são funcionalidades novas e tangíveis.
Por que isso importa
Para engenheiros de plataforma e equipes de DevOps, esta atualização da OpenAI impacta diretamente a otimização de custos em nuvem e a confiabilidade de sistemas. A redução significativa no custo dos tokens de entrada cacheados alivia a pressão orçamentária, permitindo que aplicações de IA mais sofisticadas sejam financeiramente viáveis. A capacidade de monitorar e diagnosticar o cache oferece uma camada essencial de observabilidade, crucial para manter a saúde e o desempenho de sistemas que utilizam a família GPT-6.
Além disso, a flexibilidade de ajustar o esforço de raciocínio e pré-aquecer o cache capacita as equipes a refinar a experiência do usuário e a robustez da aplicação. Ao mover o processamento para fora do tempo de espera do usuário, a latência diminui, resultando em interações mais fluidas e eficientes com os agentes de IA. Isso é vital para a automação de processos complexos e a entrega contínua de valor em ambientes produtivos.
Linha do tempo
OpenAI Otimiza Desempenho e Custo com a Nova Geração GPT-5.6
OpenAI Otimiza Custo-Benefício e Performance de Modelos GPT com Novos Modos
OpenAI Lança GPT-6 Sol e Luna: IA Mais Acessível e Rápida para Desenvolvedores
OpenAI Otimiza Cache de Prompts para GPT-6 com Melhorias de Desempenho e Economia
OpenAI revoluciona com GPT-6 Sol e Luna: IA para produtividade e automação de agentes
OpenAI Otimiza Cache de Prompts para Família GPT-6 com Descontos e Novas Ferramentas
Perguntas frequentes
O que é o cache de prompts da OpenAI para o GPT-6?
É um sistema que armazena partes repetidas de requisições enviadas ao modelo GPT-6, como instruções ou contextos compartilhados. Ao reutilizar essas informações, o sistema evita o reprocessamento, reduzindo o tempo de resposta e o custo, pois os tokens cacheados recebem descontos.
Como os descontos funcionam com o cache de prompts?
Os desenvolvedores podem obter descontos de até 90% nos tokens de entrada que são cacheados. Esses descontos são aplicados a prefixos compartilhados que são reutilizados dentro de uma janela de 30 minutos, otimizando o custo para aplicações que fazem muitas chamadas repetitivas.
Quais ferramentas estão disponíveis para gerenciar o cache de prompts?
A OpenAI lançou um Prompt Caching Dashboard para monitorar as taxas de acerto do cache da aplicação e uma ferramenta de diagnóstico para investigar perdas de cache. Essas ferramentas permitem que os engenheiros otimizem suas integrações e maximizem a eficiência do cache.
Como o cache de prompts melhora os agentes de IA?
O cache permite que agentes de IA persistentes executem tarefas complexas por horas, como refatorar código ou produzir documentos, de forma mais eficiente e econômica. A capacidade de pré-aquecer o cache e ajustar o esforço de raciocínio sem invalidá-lo reduz a latência e mantém o contexto reutilizável, tornando os agentes mais rápidos e responsivos.
Fontes
- openai.comfonte original
- Categoria
- CEVIU DevOps
- Publicado
- 25 de setembro de 2026
- Editoria
- CEVIU DevOps