
Databricks Lança Reparticionamento de Estado Sob Demanda para Apache Spark Structured Streaming
Aprofundamento CEVIU
Aprofundamento
A capacidade de otimizar cargas de trabalho em tempo real é um pilar para engenheiros de plataforma e equipes de DevOps. O lançamento do reparticionamento de estado sob demanda para Apache Spark Structured Streaming, em Public Preview no Databricks Runtime 18, resolve um ponto de dor histórico. Até então, streams estaduais de longa duração enfrentavam o dilema de ter contagens de partição fixas que, com o tempo, podiam levar a gargalos, como partições desbalanceadas ou superdimensionadas. O resultado era desperdício de recursos e degradação de desempenho.
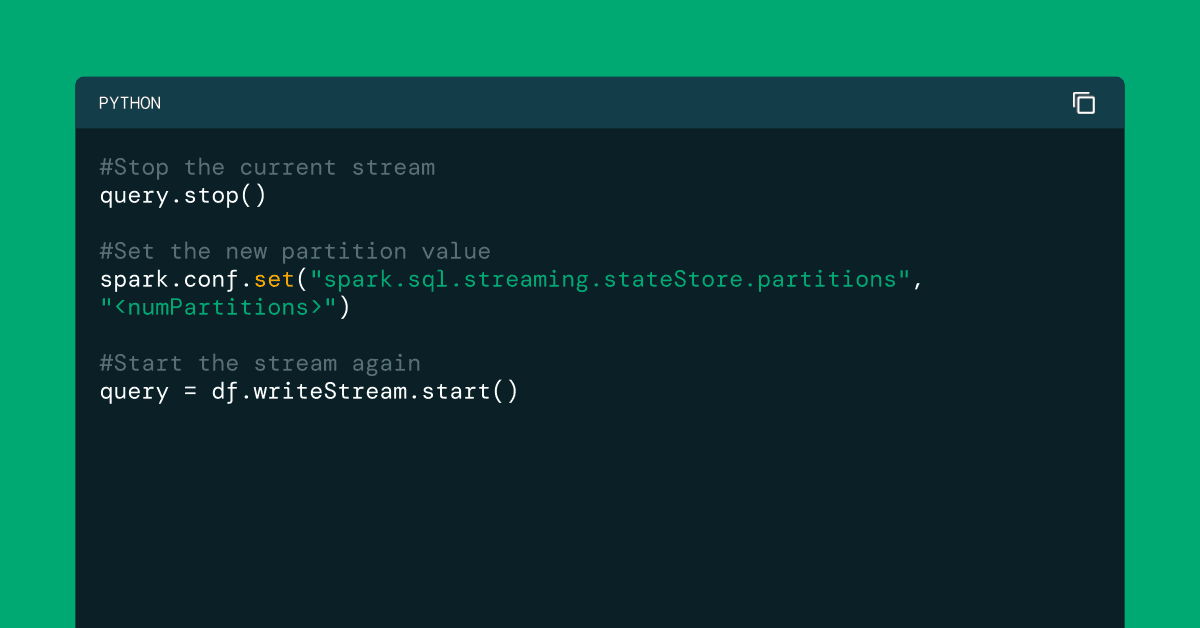
Agora, as equipes podem ajustar o número de partições dinamicamente sem a custosa necessidade de reconstruir o checkpoint ou perder o estado acumulado. A nova funcionalidade permite que um operador defina a configuração spark.sql.streaming.stateStore.partitions e reinicie a query, utilizando o RocksDB como provedor de armazenamento de estado. Isso aciona uma operação de redistribuição física do estado para o novo número de partições, mantendo a integridade dos dados e garantindo que chaves sejam re-mapeadas corretamente. É um avanço crucial para sistemas que exigem alta performance e adaptabilidade, como detecção de fraudes e monitoramento em tempo real.
O que mudou
A Databricks, com esta novidade, eleva a flexibilidade operacional do Apache Spark Structured Streaming. Historicamente, a contagem de partições em queries estaduais era 'congelada' no checkpoint. Mudar essa configuração significava abandonar o checkpoint e perder todo o estado acumulado, um cenário inviável para aplicações em produção. Essa rigidez era um desafio constante para otimização e escalabilidade.
A cobertura anterior do CEVIU, como as matérias sobre o Modo em Tempo Real (RTM) em fevereiro e março de 2026, focava na superação da barreira do microbatch e na redução da latência do streaming através de otimizações de arquitetura. Embora essas inovações tenham melhorado a velocidade de processamento, a gestão do estado ainda era um gargalo para a escalabilidade dinâmica. Agora, o reparticionamento de estado sob demanda complementa essas melhorias de performance, oferecendo controle granular sobre a infraestrutura de estado sem interrupção de serviço, tornando o que era uma decisão fixa em uma capacidade operacional flexível e responsiva.
Por que isso importa
Para equipes de SRE, DevOps e engenheiros de plataforma, este recurso representa uma ferramenta valiosa na busca por eficiência e resiliência. A capacidade de 'dimensionar corretamente' streams estaduais significa que é possível otimizar custos, reduzir o tempo de inatividade para manutenção e adaptar a infraestrutura de streaming a picos e vales de demanda sem perder dados críticos. A Coveo, por exemplo, relatou uma redução de 40% nos custos de API do Amazon S3, validando o impacto financeiro direto.
Além da economia, a nova funcionalidade melhora a confiabilidade dos sistemas. Ela permite que os engenheiros ajustem as configurações de partição para desempenho ideal após o lançamento, respondam a cargas de trabalho variáveis (como backfilling de dados históricos) e realizem ajustes finos de performance. Tudo isso é feito de forma segura e controlada, transformando uma operação de alto risco em uma ação de manutenção planejada e monitorável, garantindo que aplicações críticas de streaming mantenham a performance e a estabilidade necessárias.
Linha do tempo
Spark 4.1 introduz Structured Streaming Real-Time Mode (RTM)
Arquitetura do Modo em Tempo Real do Apache Spark aprimora microbatch
Databricks anuncia Feature Views para otimizar pipelines de ML
Apache Spark 4.2 chega com Governança de Métricas e avanços em IA
Apache Spark 4.2 lançado com inovações em métricas, SQL e geoespaciais
Spark 4.1.0 desembarca com Pipelines Declarativos e otimizações de Streaming
Databricks lança reparticionamento de estado sob demanda para Apache Spark Structured Streaming
Perguntas frequentes
O que é o reparticionamento de estado sob demanda no Apache Spark Structured Streaming?
É um novo recurso da Databricks que permite alterar o número de partições de uma query de streaming que mantém estado, sem precisar reconstruir o checkpoint ou perder dados. Isso significa que as equipes podem ajustar a capacidade de seus pipelines de dados em tempo real de forma dinâmica e segura.
Por que esse recurso é importante para as operações de streaming?
Ele resolve o problema de partições fixas que, com o tempo, podem levar a gargalos de desempenho e custos desnecessários. A capacidade de redimensionar as partições em tempo real garante que o sistema se adapte à demanda, otimizando recursos e mantendo a performance para aplicações críticas como detecção de fraudes e monitoramento.
Quais são os requisitos técnicos para utilizar o reparticionamento de estado sob demanda?
Para usar esta funcionalidade, é necessário estar no Databricks Runtime 18 ou superior e utilizar o RocksDB como provedor de armazenamento de estado. Para alterar o número de partições, basta definir a propriedade spark.sql.streaming.stateStore.partitions e reiniciar a query.
Como essa funcionalidade pode gerar economia de custos?
Ao permitir o redimensionamento dinâmico das partições, as empresas podem evitar o superdimensionamento de sua infraestrutura para picos de demanda. Isso leva a um uso mais eficiente dos recursos de computação e armazenamento. O exemplo da Coveo, que reduziu os custos de API do Amazon S3 em 40%, demonstra esse impacto financeiro direto.
Fontes
- databricks.comfonte original
- Categoria
- CEVIU DevOps
- Publicado
- 16 de setembro de 2026
- Editoria
- CEVIU DevOps