
VLLM 0.31 chega a 100% de precisão de schema em tool calls com Kimi e DeepSeek
Aprofundamento CEVIU
Aprofundamento
O problema começa no contrato entre o modelo e o agente. O harness (o artigo cita o OpenCode) manda ao modelo um JSON com as ferramentas disponíveis, cada uma com parâmetros, tipos e campos obrigatórios. Esse é o schema. O servidor de inferência embrulha essa descrição em tokens específicos do modelo e depois faz o parse da saída para devolver um JSON ao harness. Se a chamada foge do schema, ela falha.
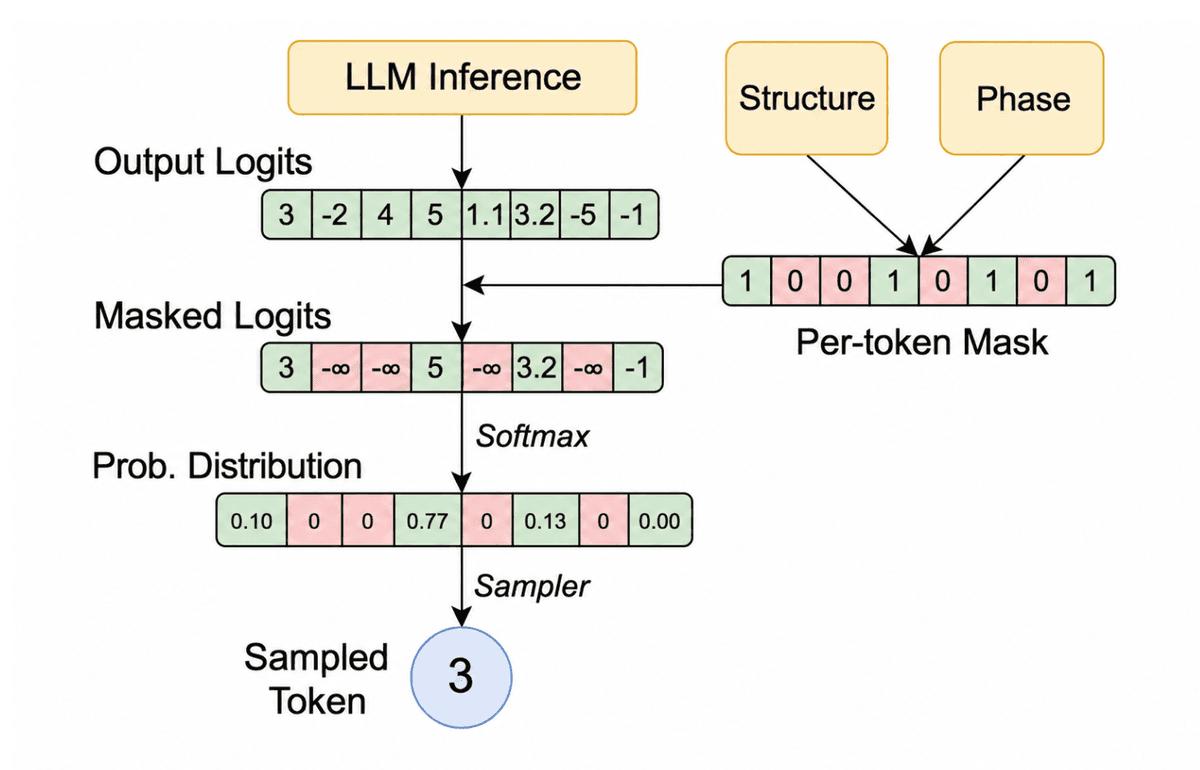
Sem constrained decoding, o modelo gera a tool call livremente, por probabilidade, e ninguém roda um type checker. Um modelo pode inventar search_web quando a ferramenta se chama web_search, ou usar city_name onde o schema pede location. Com a técnica, o vLLM usa structural tags da biblioteca XGrammar e, a cada passo, só permite tokens válidos. Na fase do índice da chamada, por exemplo, só inteiros passam. O artigo diz que o overhead é desprezível, porque as máscaras de token são pré-calculadas e aplicadas na GPU.
Na prática, a Ubicloud servindo o Kimi K2.6 no vLLM 0.28 obteve o schema esperado em 92% das vezes (2 a cada 25 chamadas falhavam), medido no benchmark K2VV ToolCall da Moonshot AI. Depois de adotar o recurso do vLLM na versão 0.25, a nota caiu para 91%. A causa não foi bug: o vLLM passou a deixar o constrained decoding desligado por padrão, por ser um motor agnóstico a modelos e o suporte ser trabalho por modelo. A solução é ligar a flag --tool-strict-level, disponível no servidor na versão 0.31. Com ela, a Ubicloud verificou 100% de precisão de schema em Kimi e DeepSeek.
O que mudou
Em 27 de outubro de 2026, o CEVIU noticiou "Ubicloud mostra como corrigir a precisão de tool calls no vLLM", com o diagnóstico: 92% de precisão no Kimi K2.6 e o constrained decoding como correção. A notícia de agora destaca o resultado e a versão: o recurso chega como flag de servidor no vLLM 0.31 e leva a 100% de schema nos modelos Kimi e DeepSeek.
Por que isso importa
Para quem opera inferência própria de modelos open-weight, a leitura é direta: o default do motor pode estar jogando fora qualidade que o benchmark do modelo promete. Vale tratar a flag de strictness como item de checklist de deploy e rodar um benchmark de tool call a cada troca de versão do vLLM, já que o padrão mudou entre releases. Menos chamadas inválidas também significa menos retries e menos contexto poluído, o que tende a pesar no custo por sessão de agente.
Linha do tempo
CEVIU noticia a correção de precisão de tool calls no vLLM pela Ubicloud, de 92% com constrained decoding.
vLLM 0.31 expõe o constrained decoding como flag de servidor e chega a 100% de schema com Kimi e DeepSeek.
Perguntas frequentes
O que é constrained decoding em tool calls?
É uma técnica em que o motor de inferência restringe, a cada passo, quais tokens o modelo pode gerar, com base no schema da ferramenta. Tokens que levariam a uma chamada inválida são mascarados. Assim, a aderência ao schema vira garantia em tempo de execução, não aposta.
Como ativar isso no vLLM 0.31?
O recurso chega como flag no servidor. O artigo menciona a opção --tool-strict-level, que permite ligar a rigidez das tool calls no deploy. Ele foi desativado por padrão porque o suporte depende de cada modelo.
Por que a precisão caiu para 91% depois de migrar para o vLLM upstream?
A implementação do constrained decoding estava correta. O que mudou foi o comportamento padrão do vLLM para requisições que não ligam o recurso explicitamente. Sem ativar, a Ubicloud voltou a ver falhas de schema.
Isso deixa a inferência mais lenta?
Segundo o artigo, o overhead é desprezível. O XGrammar pré-calcula as máscaras de token para cada fase da chamada e as aplica de forma eficiente na GPU.
Fontes
- ubicloud.comfonte original
- Categoria
- CEVIU DevOps
- Publicado
- 28 de outubro de 2026
- Editoria
- CEVIU DevOps