
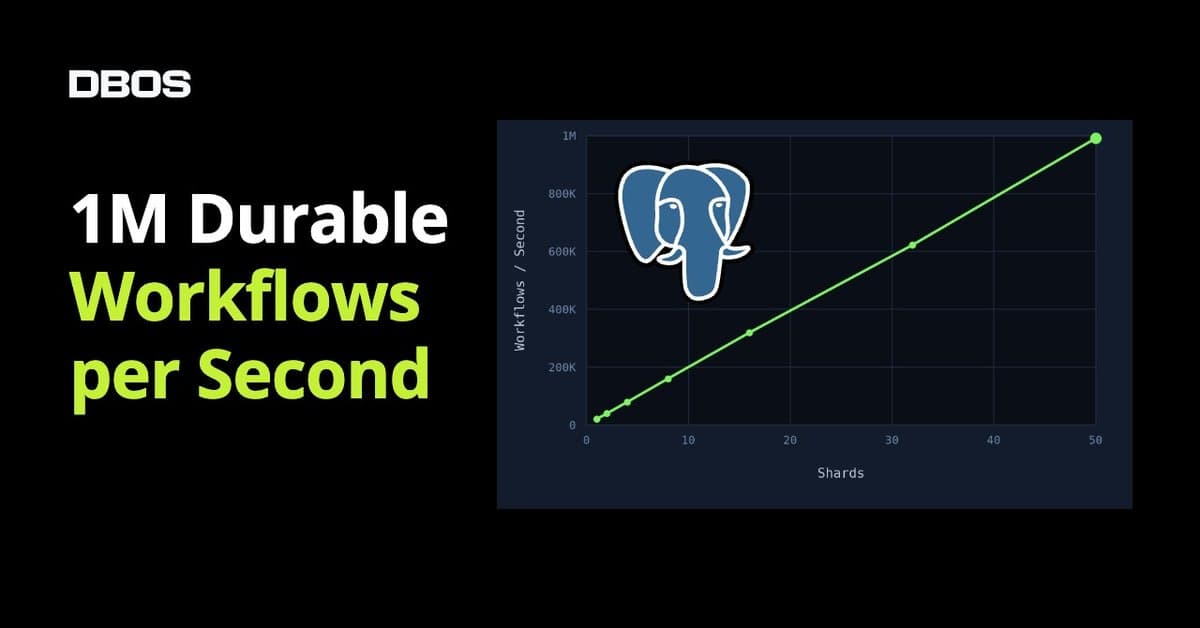
DBOS chega a 1 milhão de durable workflows por segundo no Postgres com sharding via PgDog
Aprofundamento CEVIU
Aprofundamento
A DBOS mediu durable workflows no-op (sem steps) em Postgres sharded com PgDog. O resultado escalou de forma linear: 20 mil workflows por segundo com um servidor RDS db.m7i.4xlarge (16 cores, 64 GB de RAM) até 1 milhão por segundo com 50 shards. Foram 48 processos worker por shard, 2.400 no total, todos conectados a um roteador PgDog no próprio host. Os workflows entram numa única fila durável, com shard key aleatória uniforme.
Para a escala ser linear, cada operação de um workflow precisa cair em um único shard. Por isso a DBOS adicionou a coluna shard_key à tabela workflow_status e às dependentes, como workflow_steps. O dequeue também passou a ser por shard: cada processo percorre os shards um de cada vez. O problema apareceu entre 8 e 16 shards (cerca de 200 mil workflows/s). Qualquer perturbação, como um VACUUM grande, derrubava o cluster inteiro sem recuperação. A causa era um loop de feedback no dequeue com FOR UPDATE SKIP LOCKED: dequeues mais lentos atraem mais processos concorrentes, que geram mais contenção de lock, e a query precisa varrer mais linhas bloqueadas até achar uma livre. A correção foram advisory locks do Postgres, com poucos "dequeue locks" por shard. Quem não consegue o lock não espera e passa para o próximo shard.
O que mudou
Em 1 de maio de 2026, o CEVIU noticiou "Escala da Execução de Workflows no Postgres": um único servidor sustentava 144 mil escritas brutas e 43 mil workflows duráveis por segundo, com gargalos em WAL flushing e contenção de lock de tabela. Agora o teste usa 20 mil workflows/s por shard como teto sustentável e vai a 1 milhão por segundo com sharding. O gargalo relevante também mudou: em escala horizontal, o problema foi a contenção no dequeue, não o WAL de um nó. Os números dos dois testes não são diretamente comparáveis, já que o material não detalha se a configuração é a mesma.
Por que isso importa
Para quem opera filas ou orquestração sobre Postgres, a leitura é que sharding sozinho não basta. Se o seu worker faz polling com SKIP LOCKED em muitos processos, vale observar a latência do dequeue por shard e limitar a concorrência. Um VACUUM pesado pode virar incidente global sem esse freio. Em custo, o teste mostra o preço da escala: 50 instâncias RDS de grande porte para 1 milhão por segundo, num benchmark de workflows no-op.
Linha do tempo
CEVIU noticia que um Postgres único sustenta 43 mil workflows duráveis por segundo.
DBOS chega a 1 milhão de workflows por segundo com 50 shards e PgDog, usando advisory locks no dequeue.
Perguntas frequentes
O Postgres escala para 1 milhão de workflows por segundo?
Com sharding, sim, segundo o benchmark da DBOS. Foram 50 servidores Postgres com PgDog, cada um sustentando 20 mil workflows por segundo. Os workflows eram no-op, sem steps, então cargas reais podem render menos.
O que causava a queda de desempenho acima de 8 a 16 shards?
Um loop de feedback de contenção no dequeue. Quando um shard desacelerava, mais processos tentavam desenfileirar dele ao mesmo tempo, o que aumentava a disputa por locks e deixava as queries ainda mais lentas. O resultado era um colapso que não se recuperava.
Como os advisory locks resolveram o problema?
Cada shard tem poucos dequeue locks. O processo precisa obter um para desenfileirar e, se não conseguir, segue para o próximo shard sem esperar. Isso limita a concorrência por shard e quebra o loop.
Preciso usar o PgDog para obter esse resultado?
Não necessariamente. A DBOS afirma que resultados semelhantes são possíveis com qualquer engine de sharding e cita Citus, Neki e Multigres como alternativas. O PgDog foi escolhido por ser leve e open-source.
Fontes
- dbos.devfonte original
- Categoria
- CEVIU DevOps
- Publicado
- 30 de outubro de 2026
- Editoria
- CEVIU DevOps