
Backup verde não garante restauração: o risco escondido nos backups de PostgreSQL
Aprofundamento CEVIU
Aprofundamento
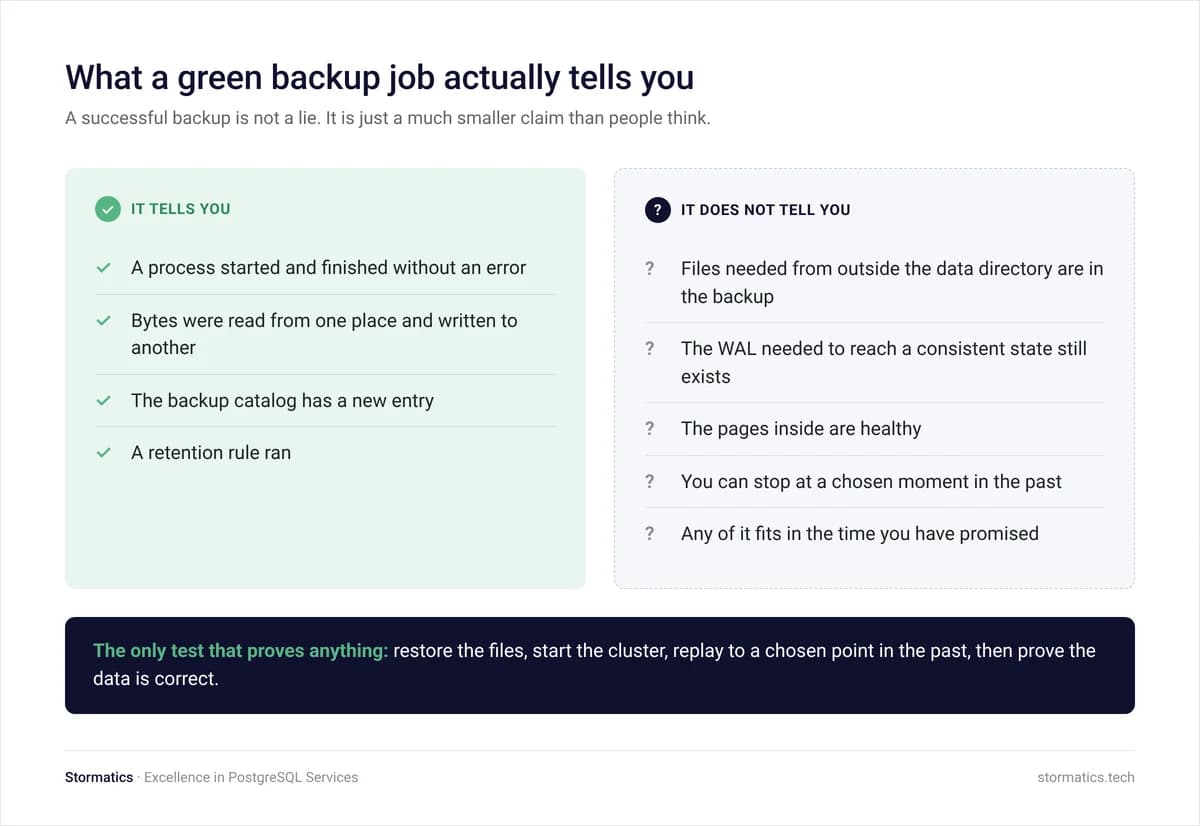
O texto do blog Semab's Planet PostgreSQL (Stormatics) parte de um ponto simples: backup verde diz que um processo começou e terminou sem erro, que bytes foram copiados e que o catálogo ganhou uma entrada. Não diz nada sobre recuperação. O autor monta um incidente-padrão, não um caso real de uma empresa: uma coluna com dados vivos é removida às 09:38, a equipe decide restaurar para antes disso e descobre que não existe host de restauração. O restore termina às 13:50 e para antes do ponto desejado, porque falta um segmento de WAL no arquivo. Às 16:30 a equipe recorre a uma cópia de seis dias atrás. A expectativa de uma hora virou mais de dois dias, com perda de dados certa.
As causas listadas são: cadeia de WAL quebrada, corrupção copiada fielmente para todos os backups, retenção desalinhada entre WAL e backup completo, itens fora do diretório de dados (roles, configurações, extensões, tablespaces, certificados), chave de criptografia perdida, ausência de máquina para restaurar e falta de pessoas que saibam fazer. Um ponto técnico forte é o arquivamento de WAL: ele falha em silêncio, porque não derruba o banco nem o job de backup. O primeiro sinal costuma ser pressão de disco em pg_wal, e liberar espaço transforma um problema temporário em permanente. A recomendação é monitorar separadamente a contagem de falhas de arquivamento, a idade do segmento arquivado mais recente e o tamanho de pg_wal. O único teste que prova algo é restaurar, subir o cluster, reproduzir até um ponto no passado e validar os dados.
Por que isso importa
Para quem opera PostgreSQL em produção, a leitura prática é trocar a pergunta "o backup rodou?" por "quanto tempo leva para voltar e até qual ponto?". Isso pede métricas próprias para o arquivamento de WAL e um teste periódico de restauração, com data registrada do último sucesso. Sem isso, o painel verde mede o job, não a capacidade de recuperação.
Perguntas frequentes
Por que um backup de PostgreSQL concluído com sucesso pode falhar na restauração?
Porque o sucesso do job só indica que o processo terminou sem erro. Ele não garante que o WAL necessário exista, que as páginas estejam íntegras, que arquivos fora do diretório de dados estejam incluídos ou que a chave de criptografia esteja acessível.
O que monitorar além do job de backup?
O texto recomenda acompanhar três itens separados: a contagem de falhas de arquivamento, a idade do segmento de WAL arquivado com sucesso mais recente e o tamanho de pg_wal. O arquivamento tem modo de falha próprio e não derruba o backup.
Retenção de 30 dias protege contra corrupção?
Não necessariamente. Se uma página danificada entra em todos os backups, os 30 dias viram o prazo para perceber o problema. Depois disso, a última cópia limpa expira e o dano está em todas as cópias.
Como testar a restauração de forma que prove algo?
Restaure os arquivos em uma máquina limpa, suba o cluster, reproduza o WAL até um ponto escolhido no passado e confirme que os dados estão corretos. O autor sugere fazer isso com um banco real, para um horário da semana anterior, com outra pessoa operando.
Fontes
- stormatics.techfonte original
- Categoria
- CEVIU Dados
- Publicado
- 02 de novembro de 2026
- Editoria
- CEVIU Dados