
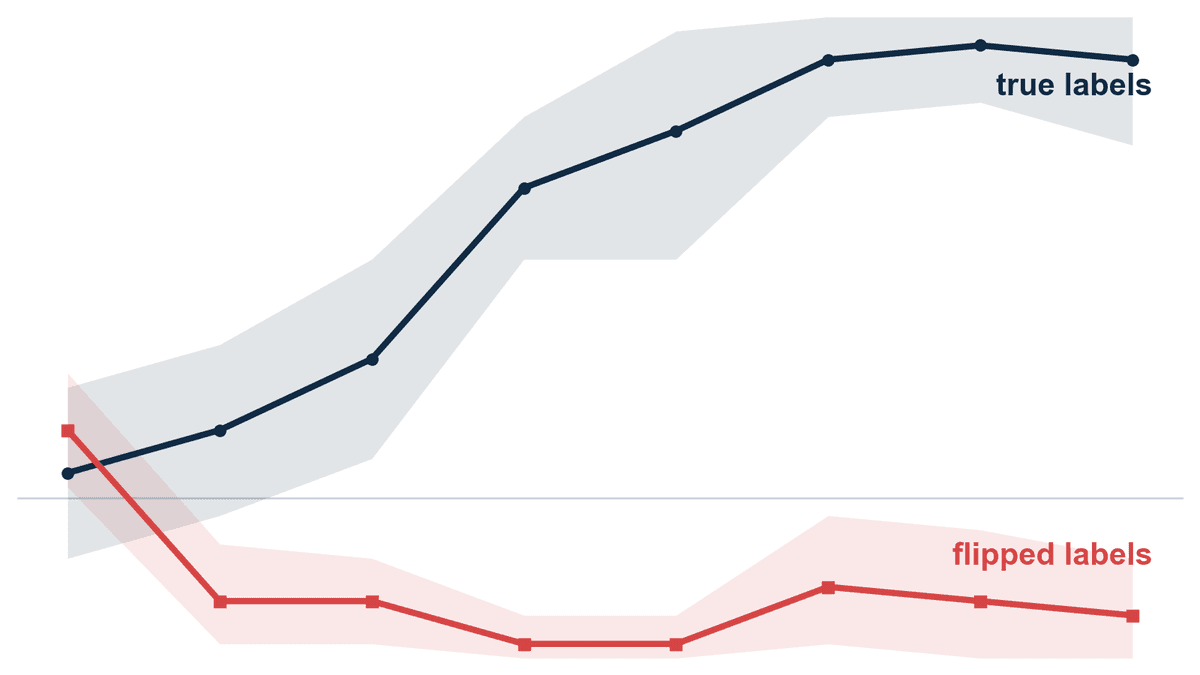
Teste com rótulos de recompensa invertidos mostra que o GPT-6 Sol foi o modelo que mais acreditou no feedback falso
Aprofundamento CEVIU
Aprofundamento
O teste gira em torno dos labels (rótulos de recompensa): um número ao lado de cada tentativa passada na memória de um agente, 1 para acerto e 0 para erro. Essa memória é só texto no prompt, sem retreino do modelo. O autor do teste (o artigo não o identifica no material) inverteu os rótulos para ver se o modelo realmente os lê. Não é um projeto de software com repositório localizado na fonte, e sim um experimento descrito em artigo.
A tarefa era escolher entre quatro rotas (Kiwi, Plum, Fig e Lime) para pedidos fictícios. Só a região importava, e uma regra oculta sorteada a cada execução ligava região a rota. Com memória própria do agente (24 pedidos seguidos), o GPT-6 Sol foi de 32,2 para 94,4 com rótulos verdadeiros e de 22,2 para 7,8 com invertidos. O Claude Haiku 5.5 foi de 21,1 para 37,2, mas ficou em 25,0 com rótulos invertidos. O Qwen3 4B Instruct ficou plano (30,6 e depois 32,8) com rótulos verdadeiros. Na memória fixa de oito pedidos, o Haiku seguiu os rótulos invertidos (9,4), sem que o autor tenha achado a causa da diferença.
Há limites claros: uma tarefa, três modelos, o GPT-6 Sol com desenho menor (15 execuções online por condição) e um suplemento do Qwen adicionado depois de uma regra de parada disparar. Os intervalos iniciais eram estreitos demais e foram refeitos reamostrando sementes. O teste todo custou cerca de 2,55 dólares em API.
Por que isso importa
Para quem opera agentes com memória de tentativas pontuadas, a leitura é pragmática: não dá para presumir que o score está sendo lido, nem que está sendo ignorado. O teste de inversão é barato (0,36 dólar no Haiku, segundo o autor) e diz se o desenho de recompensa faz algum trabalho. É um resultado de uma tarefa sintética, não uma regra geral.
Perguntas frequentes
O que é um rótulo de recompensa na memória de um agente?
É um número ao lado de uma tentativa passada, nesse teste 1 para acerto e 0 para erro. A lista de tentativas vai no prompt, e o modelo não é retreinado. Quando o modelo melhora só por ver esses exemplos, isso se chama aprendizado em contexto.
Como o teste inverteu os rótulos e o que aconteceu com o GPT-6 Sol?
Todos os 1 e 0 foram trocados. Com isso, o GPT-6 Sol caiu para 7,8 em 100 nas últimas seis tentativas, contra 94,4 com rótulos verdadeiros. Cair abaixo do acaso (25) indica que ele seguiu os rótulos errados.
Isso contradiz o artigo que diz que recompensas importam pouco?
Segundo o autor, não. O artigo Do LLMs Learn from Rewards in Context?, submetido em 8 de outubro de 2026, relata que inverter ou remover recompensas muda pouco as curvas. Aqui a regra oculta só podia ser descoberta pelos rótulos, então ignorá-los não deixava nada a aprender.
Como testar isso no meu próprio agente?
Inverta os rótulos em um teste pequeno e veja se o score muda. Se não mudar, o agente provavelmente não aprende com eles. O autor também sugere testar memória sem rótulos e só com sucessos, mas avisa que isso vai além do que ele testou.
Fontes
- towardsdatascience.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 02 de novembro de 2026
- Editoria
- CEVIU Dados