
Como a Canva automatiza a criação de uma camada semântica com comentários SQL
Aprofundamento CEVIU
Aprofundamento
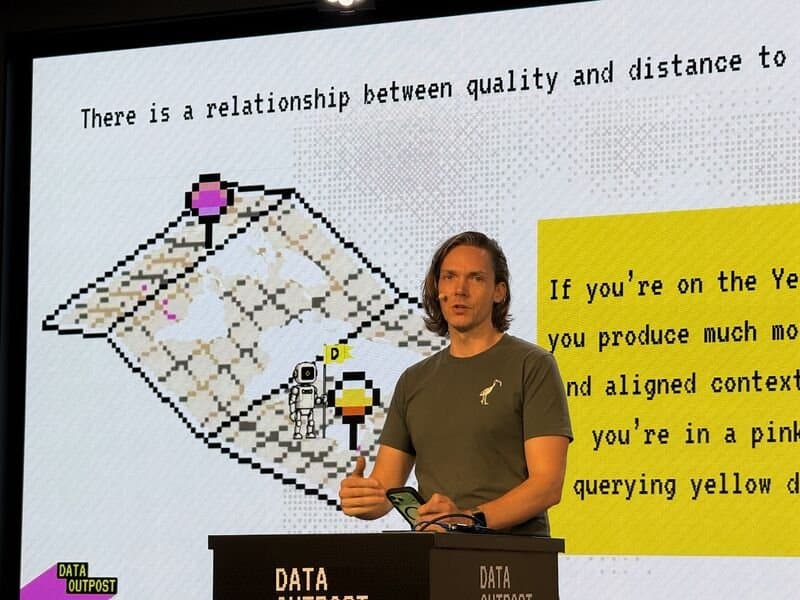
A ideia central apresentada por Sam Redfern, staff data scientist da Canva, no Data Outpost da MotherDuck é simples: os próprios usuários escrevem o contexto de negócio da camada semântica sem saber que estão fazendo isso. Ele começou a testar em 2024, colando histórico de consultas em um LLM para escrever SQL sobre tabelas que ainda não conhecia. Isso virou um agente de dados interno baseado em MCP. Hoje cerca de 90% dos cientistas de dados da Canva usam as ferramentas de IA internas toda semana, e perto de 10% da empresa também.
O truque está em poucas linhas na descrição da ferramenta. Toda vez que o agente roda SQL, ele adiciona dois comentários: para que serve a consulta e quais termos de negócio ou jargões internos aparecem nela. As sessões têm de 20 a 50 consultas, muitas vezes começando por uma pergunta colada do Slack. O resultado é um registro contínuo de como as pessoas falam do negócio. Para minerar isso, a equipe se inspirou na pesquisa Clio, da Anthropic: levanta os principais tópicos por departamento, encontra sinônimos (um time diz "learning activations", outro "first lesson"), decifra siglas de três letras sobrepostas e monta evals.
Os evals incluem casos do que o agente não deve responder, como ranquear gestores por atrito de equipe só porque achou uma tabela de histórico de RH. Há limites: quem é dono de um dataset fala dele de forma muito diferente de quem pergunta, então são necessários os dois vocabulários. Os comentários também raramente registram a conclusão final da sessão, o que Sam vê como ganho de privacidade.
O que mudou
A cobertura anterior não mostra evolução do mesmo projeto da Canva, mas traz abordagens vizinhas. Em 9 de março de 2026, o CEVIU noticiou "Embeddings Unificados de Contexto e Intento para Text-to-SQL Escalável", em que o Pinterest usa o histórico de queries de mais de 2.500 analistas para alimentar seu Analytics Agent. A Canva segue lógica parecida (aproveitar consultas reais), mas acrescenta comentários estruturados gerados pelo agente no momento da execução.
Por que isso importa
Para quem opera plataformas de dados, a leitura é que documentar a camada semântica à mão tende a ficar para trás, e capturar o contexto no uso pode ser mais barato. Para quem constrói agentes, o recado sobre evals negativos pesa: governança também precisa testar o que o agente deve recusar.
Linha do tempo
CEVIU noticia o Analytics Agent do Pinterest, que usa histórico de queries para Text-to-SQL.
Canva detalha como automatiza a camada semântica com comentários SQL do agente de dados.
Perguntas frequentes
Como a Canva gera contexto para a camada semântica?
O agente de dados adiciona dois comentários a cada SQL executado: a finalidade da consulta e os termos de negócio ou jargões envolvidos. Esses comentários se acumulam em sessões de 20 a 50 consultas. A equipe então analisa o material para extrair temas, sinônimos e siglas.
Para que servem os evals de respostas inseguras?
Eles testam o que o agente não deveria responder. O exemplo citado é ranquear gestores por atrito de equipe ao encontrar uma tabela de histórico de RH. Segundo Sam Redfern, esses casos são mais preocupantes do que os de respostas esperadas.
Qual é a limitação dessa abordagem?
O time dono de um dataset fala sobre ele de forma bem diferente de quem pergunta, então é preciso reunir os dois vocabulários. Além disso, os comentários normalmente não registram a conclusão da sessão. Sam vê isso como um ponto positivo para a privacidade.
Que conselhos Sam Redfern dá a outras equipes?
Usar um agente de dados que dê para customizar, construir o contexto semântico e investir tempo em gerá-lo, e exigir o output completo (incluindo traces) de quem fornece inferência. Depois, ler esses traces. A Canva também faz sessões em que uma pessoa observa um colega usando IA.
Fontes
- linkedin.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 09 de novembro de 2026
- Editoria
- CEVIU Dados