
Apache Hudi-rs 0.6.0 traz escrita nativa em Rust e Python, sem Spark nem JVM
Aprofundamento CEVIU
Aprofundamento
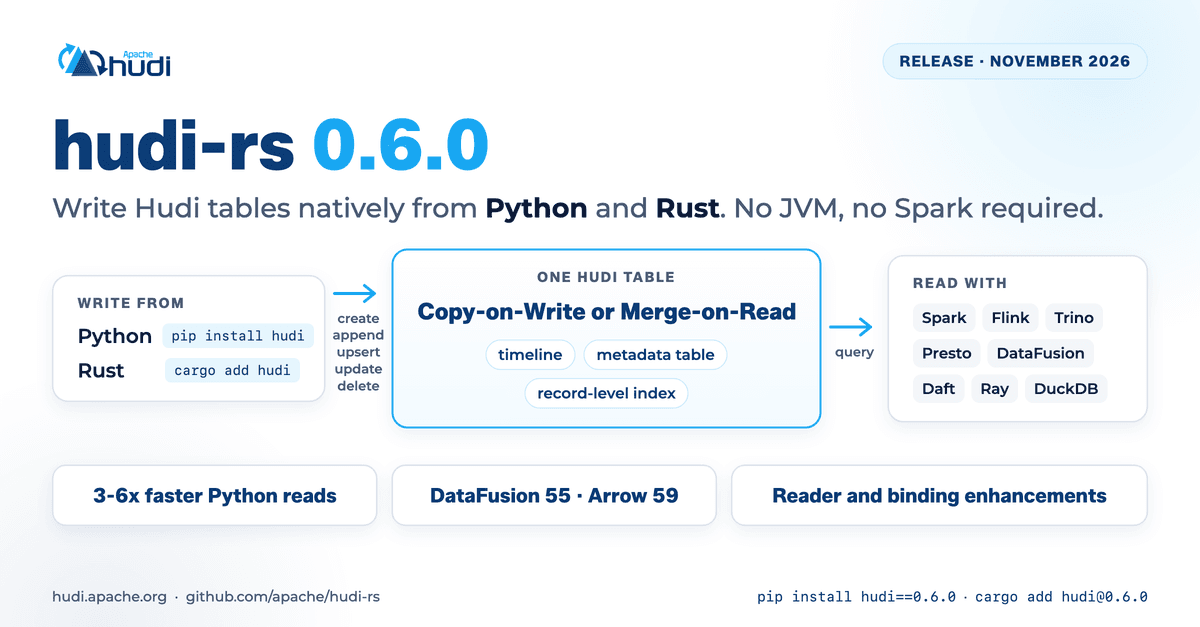
O hudi-rs é a implementação nativa em Rust do Apache Hudi, com bindings para Python e C++. Até a versão 0.5.0 ele era só leitor: servia para consultar tabelas Hudi sem JVM, a partir de Rust, Python, DataFusion, Daft e Ray. A 0.6.0 adiciona escrita nativa em nó único: create, append, upsert, update, delete, overwrite e dynamic partition overwrite, em tabelas Copy-on-Write e Merge-on-Read. Instala-se com pip install hudi ou cargo add hudi.
Cada escrita é um commit atômico na timeline do Hudi, e uma escrita que falha no meio sofre rollback automático. A tabela de metadados (listagem de arquivos, estatísticas de coluna e partição, índice em nível de registro) é atualizada a cada commit. Em Merge-on-Read, upserts e deletes vão para arquivos de log, e a nova compactação junta esses logs em arquivos base. O upsert localiza os registros pelo índice de registro, sem varrer a tabela. Spark, Flink, Trino e Presto leem o resultado, mas os escritores são serializados só dentro de um processo, então não se deve escrever na mesma tabela por dois engines ao mesmo tempo.
No benchmark do projeto (cinco workloads, cada um com carga inicial, cinco commits de upsert e cinco de delete), o hudi-rs foi de 1,2 a 12 vezes mais rápido em upserts que o melhor entre delta-rs e PyIceberg. Em deletes, foi de 4,8 a 24 vezes mais rápido, exceto em tpcds-web-returns, onde ficou parecido com o delta-rs. Há um custo: a carga inicial da tabela uuid de 10 milhões de linhas leva 5,7 s no Hudi, contra 2,8 s no delta-rs e 1,3 s no PyIceberg, porque cerca de 2,4 s vão para montar a tabela de metadados e o índice. Na leitura em Python, tabelas locais Copy-on-Write de 1M a 10M de linhas ficaram de 3,8 a 6 vezes mais rápidas (2,11 s para 0,35 s em 10M). Um point lookup por chave caiu de 2,00 s para 0,08 s. O release também sobe para DataFusion 55, Arrow e Parquet 59, e amplia a compatibilidade de leitura com tabelas escritas por Spark e Flink.
O que mudou
Em 17 de agosto de 2026, o CEVIU noticiou "Apache Hudi Otimiza Buscas em Lakehouse com Índices para Workloads de Leitura", sobre o uso de índices de metadados para deixar leituras seletivas mais próximas de buscas diretas. A 0.6.0 do hudi-rs leva esse tipo de índice ao caminho Rust e Python: o índice em nível de registro agora serve tanto para localizar linhas em upserts e deletes quanto para point lookups na leitura.
Em 11 de julho de 2026, o CEVIU noticiou "Apache Hudi revoluciona Lakehouses com Busca Vetorial Nativa", voltado a busca semântica e RAG. O exemplo de pipeline de recuperação com chunks e embeddings da nova versão aponta para o mesmo tipo de uso, agora sem Spark.
Por que isso importa
Para quem opera pipelines de RAG, curadoria de datasets de treino ou serviços que corrigem registros aos poucos, isso significa atualizar uma tabela Hudi de um script Python sem subir cluster. A leitura incremental a partir do tempo de commit e o time travel ajudam a reprocessar só o que mudou e a reproduzir a versão usada em um treino. O custo na carga inicial e a escrita limitada a nó único indicam que, quando a tabela crescer, o desenho natural é entregá-la ao Spark para ingestão, compactação e clustering.
Linha do tempo
CEVIU noticia a busca vetorial nativa no Apache Hudi para RAG.
CEVIU noticia índices de metadados do Hudi para workloads de leitura.
hudi-rs 0.6.0 chega com escrita nativa em Rust e Python, sem Spark nem JVM.
Perguntas frequentes
O hudi-rs 0.6.0 escreve tabelas Hudi sem Spark e sem JVM?
Sim. A versão adiciona escrita nativa em Rust e Python, com create, append, upsert, update, delete e overwrite. A escrita é em nó único e vale para tabelas Copy-on-Write e Merge-on-Read. Spark, Flink, Trino e Presto conseguem ler as tabelas escritas.
Posso escrever na mesma tabela com hudi-rs e Spark ao mesmo tempo?
Não é o recomendado. O hudi-rs serializa escritores apenas dentro de um processo. A orientação do projeto é passar a tabela de um engine para outro, em vez de escrever por dois engines simultaneamente.
Qual o ganho de desempenho do release?
Nos benchmarks do projeto, upserts ficaram de 1,2 a 12 vezes mais rápidos que delta-rs e PyIceberg, e deletes de 4,8 a 24 vezes. Leituras completas em Python ficaram de 3,8 a 6 vezes mais rápidas. A carga inicial, porém, é mais lenta em alguns workloads, por causa da construção do índice.
Que tipos de dados o write aceita em Python?
Os métodos de escrita ficam em HudiTable e aceitam dados Arrow: tabela, record batch ou reader do PyArrow. Também aceitam qualquer objeto com a interface Arrow PyCapsule, como DataFrames do Polars ou do pandas 2.2 ou superior, sem dependência extra.
Fontes
- hudi.apache.orgfonte original
- Categoria
- CEVIU Dados
- Publicado
- 05 de novembro de 2026
- Editoria
- CEVIU Dados