
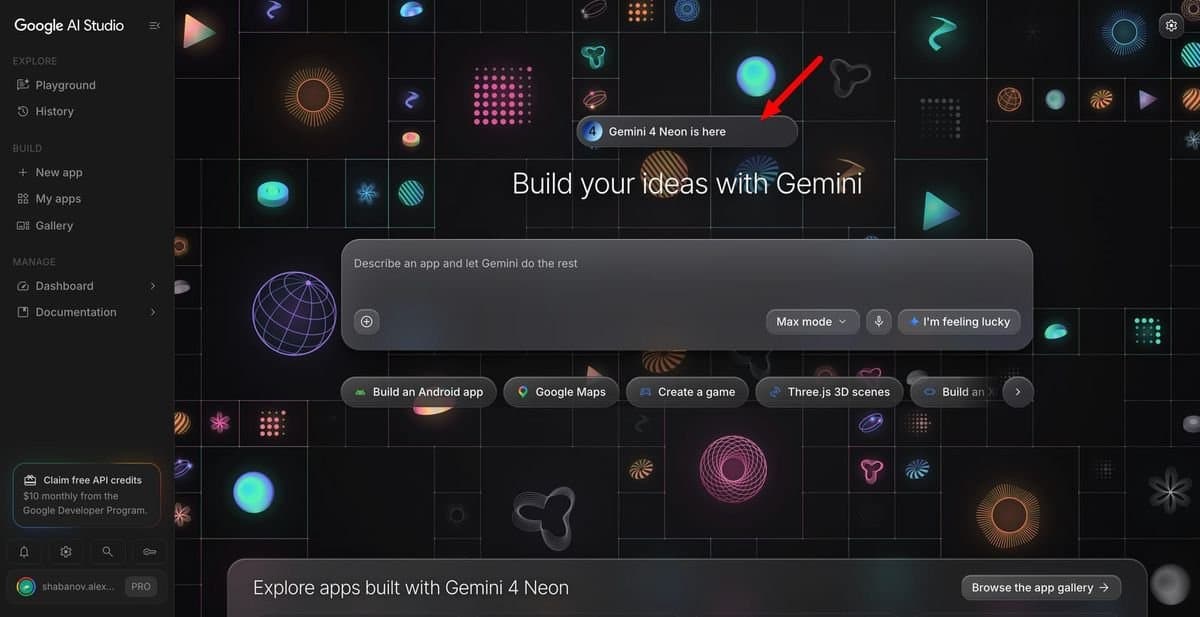
Google lança Gemini 4 Neon com janela de contexto de 1 milhão de tokens
Aprofundamento CEVIU
Aprofundamento
O Google lançou oficialmente o Gemini 4 Neon, um novo modelo da família Gemini 4 que foca em inteligência de ponta com conclusão rápida de tarefas. Ele é destinado a engenharia de software, trabalho de conhecimento e ciência. O Neon está disponível no nível pago da API Gemini, no Google AI Studio, no Android Studio, e no Gemini for business via API. Assinantes Pro e Ultra do Google AI e do aplicativo Gemini também têm acesso, assim como membros elegíveis do Fairwind Program, que receberão uma versão de ciberdefesa.
O modelo se posiciona entre o Gemini 4 Carbon (para projetos complexos de longo prazo) e o Gemini 4 Hydrogen (para execução rápida de tarefas diárias). O custo é de US$3 por milhão de tokens de entrada e US$15 por milhão de tokens de saída, com entrada em cache a US$0,15. Ele suporta planilhas, PDFs, gráficos, áudio e vídeo, tudo dentro de uma janela de contexto de 1 milhão de tokens. O Neon oferece quatro níveis de raciocínio, permitindo equilibrar inteligência e custo, e no nível padrão “high” é 32% mais barato por tarefa que o Carbon. Em testes, o Neon alcançou 61 no Artificial Analysis Intelligence Index e ficou em primeiro lugar no Artificial Analysis Coding Agent Index com 58.6 pontos.
O que mudou
A família Gemini 4 está se expandindo rapidamente. Em 11 de novembro de 2026, o CEVIU noticiou o lançamento do Gemini 4 Carbon, descrito como o modelo mais forte do Google, voltado a programação complexa e raciocínio científico. Dois dias depois, em 13 de novembro de 2026, veio o Gemini 4 Hydrogen, focado em codificação rápida e execução de agentes, com uma janela de contexto de um milhão de tokens e um custo de US$1,50 por milhão de tokens de entrada. Agora, o Gemini 4 Neon preenche uma lacuna entre o Carbon e o Hydrogen, oferecendo um equilíbrio entre inteligência de ponta e rapidez, com um custo intermediário (US$3 por milhão de tokens de entrada) e a mesma janela de contexto de 1 milhão de tokens.
Por que isso importa
Para desenvolvedores e engenheiros, o Gemini 4 Neon representa uma opção de IA mais eficiente para fluxos de trabalho complexos e de alta frequência. A capacidade de processar 1 milhão de tokens em sua janela de contexto, aliada ao suporte a múltiplos formatos como planilhas e vídeo, significa menos interrupções e mais dados processados em uma única interação. A otimização de custos, sendo 32% mais barato que o Carbon por tarefa, permite que equipes de desenvolvimento otimizem seus gastos com IA enquanto mantêm alto nível de desempenho. Isso é particularmente útil para automação de tarefas de engenharia de software e análise de grandes volumes de dados.
Linha do tempo
Google lança Nano Banana 2.1, parte da família Gemini 3, com capacidade multimodal de 1 milhão de tokens.
Google lança Gemini 4 Carbon, seu modelo mais forte, via API e para assinantes.
Google apresenta o Gemini 4 Hydrogen, modelo voltado a codificação rápida e execução de agentes.
Google lança Gemini 4 Neon com janela de contexto de 1 milhão de tokens.
Perguntas frequentes
O que é o Gemini 4 Neon?
É um novo modelo de inteligência artificial do Google, parte da família Gemini 4, projetado para tarefas que exigem inteligência de ponta com rápida conclusão. Ele se posiciona entre o Gemini 4 Carbon e o Gemini 4 Hydrogen.
Qual a principal característica do Gemini 4 Neon?
Sua principal característica é a janela de contexto de 1 milhão de tokens, que permite processar grandes volumes de dados em uma única interação. Ele também suporta diversos formatos como texto, planilhas, PDFs, gráficos, áudio e vídeo.
Onde o Gemini 4 Neon pode ser usado?
Ele está disponível para desenvolvedores via API Gemini, no Google AI Studio e no Android Studio. Empresas podem acessá-lo via Gemini for business. Assinantes Google AI Pro e Ultra, e usuários do aplicativo Gemini, também têm acesso.
Quais os custos de uso do Gemini 4 Neon?
Os custos são de US$3 por milhão de tokens de entrada e US$15 por milhão de tokens de saída. Há também um custo de US$0,15 para cada milhão de tokens de entrada em cache.
Fontes
- testingcatalog.comfonte original
- Categoria
- CEVIU
- Publicado
- 19 de novembro de 2026
- Editoria
- CEVIU