
GitHub sobrecarregado pela explosão da IA: entenda os impactos
Aprofundamento CEVIU
Aprofundamento
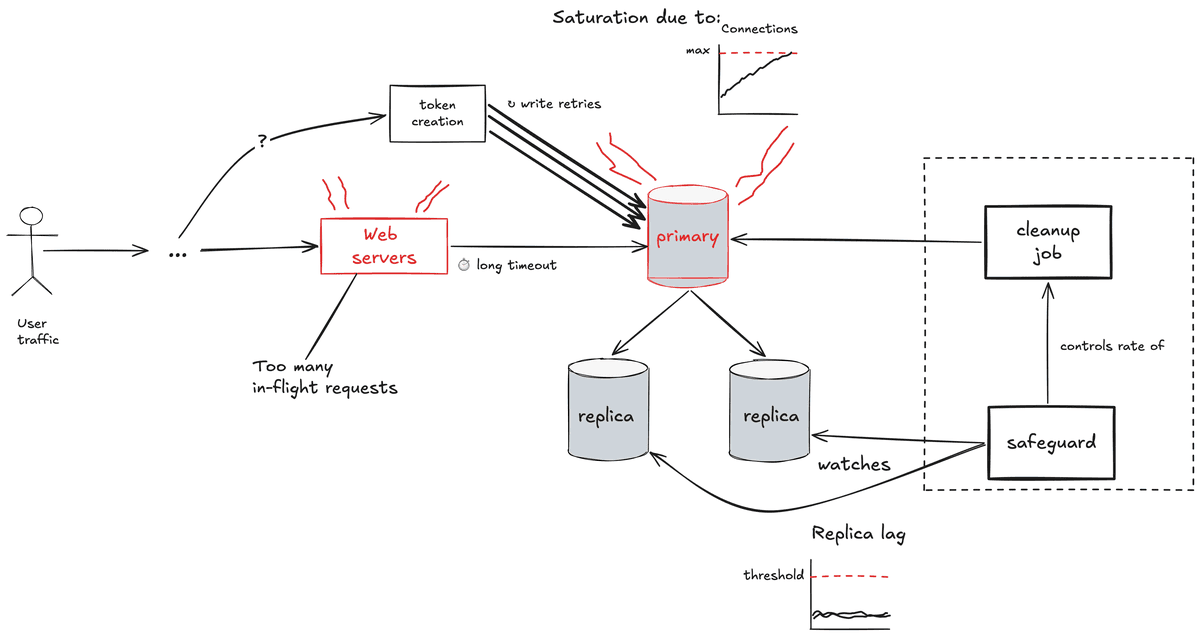
A recente interrupção no GitHub, ocorrida em 13 de setembro de 2026, é mais um reflexo da pressão que a explosão da IA tem exercido sobre a infraestrutura da plataforma. O incidente específico foi causado por um trabalho interno de limpeza de dados que, ao gravar em um cluster de banco de dados compartilhado, saturou o nó primário. O ponto crítico: o sistema de salvaguarda monitorava apenas o atraso das réplicas, sem considerar a carga no servidor principal. Com isso, o job continuou escrevendo enquanto o primário, silenciosamente, atingia seu limite de conexões.
Quando o primário ficou sem conexões, as requisições autenticadas não conseguiam completar. A falta de um timeout rápido nos manipuladores de requisição fez com que as solicitações ficassem presas, esgotando a capacidade do servidor web e levando a erros generalizados. Para piorar, um loop de retentativas na criação de tokens manteve o banco de dados saturado, dificultando a recuperação. A equipe de resposta mitigou o problema reduzindo a carga interna e pausando o job, mas o episódio expõe fragilidades que o CEVIU News vem acompanhando há meses.
O que mudou
O CEVIU News tem reportado desde abril de 2026 sobre como o crescimento exponencial da IA estressava a infraestrutura do GitHub. Em abril e maio de 2026, matérias como "Atualização sobre a Disponibilidade do GitHub" e "A Vida Acelera Rapidamente" já alertavam sobre o aumento da carga e os riscos de saturação. Em junho de 2026, noticiamos em "Os planos do GitHub para a era dos agentes de IA" e "Código gerado por IA exige nova infraestrutura de Git" sobre o crescimento de 1.400% no volume de código e a necessidade de uma infraestrutura mais robusta.
Agora, o que antes era um alerta geral e uma promessa de "priorizar a confiabilidade" se transformou em uma análise técnica detalhada de um incidente real e um plano de ação concreto. O GitHub não está mais apenas diagnosticando a pressão externa da IA, mas desdobrando intervenções específicas. São elas: limitar a taxa de jobs em segundo plano, implementar pausas automáticas baseadas na carga do servidor primário (não apenas no atraso da replicação), aprimorar o monitoramento, limitar retentativas e fragmentar o cluster de banco de dados para isolar pontos de falha. A narrativa evoluiu da constatação do problema para a engenharia de soluções.
Por que isso importa
Este incidente é um estudo de caso fundamental em engenharia de resiliência. Ele ilustra a complexidade de manter sistemas distribuídos sob cargas extremas, especialmente quando um fator externo como a IA acelera o ritmo de uso de forma imprevista. Para desenvolvedores e equipes de operações, a lição é clara: a percepção de saúde de um sistema pode ser enganosa (o chamado "gray failure"), e métricas incompletas, timeouts mal configurados e retentativas excessivas podem transformar um pequeno problema em uma interrupção em cascata.
A resposta do GitHub, focando em mais monitoramento, quebra de clusters e reajuste de lógicas de retry, é um lembrete de que a confiabilidade é uma busca contínua, que frequentemente exige adicionar mais complexidade. Este caso ressalta a importância de antecipar e mitigar riscos de saturação, especialmente em sistemas que lidam com tráfego e processos de alto volume, como os impulsionados por IA.
Linha do tempo
GitHub atribui interrupções ao crescimento acelerado de desenvolvimento impulsionado por IA.
CEVIU News reporta que o crescimento por IA aumenta carga e ritmo operacional em plataformas como GitHub, com riscos de saturação.
Outages do GitHub no início de maio são ligadas a aumento de tráfego de agentes de IA, pressionando a infraestrutura Git.
Análise do CEVIU News indica que código gerado por IA exige nova infraestrutura de Git.
CEVIU News detalha que agentes de IA causaram crescimento de 1.400% no volume de código, pressionando a infraestrutura do GitHub.
Proliferação de repositórios e pull requests gerados por IA sobrecarrega mantenedores de código aberto.
GitHub é sobrecarregado pela explosão da IA, com novo incidente técnico detalhado.
Perguntas frequentes
O que causou a recente interrupção no GitHub em 13 de setembro de 2026?
A interrupção foi resultado de um job interno de limpeza de dados que saturou um cluster de banco de dados compartilhado. O sistema de monitoramento não detectou o esgotamento das conexões no servidor primário, permitindo que o job continuasse sobrecarregando o sistema.
O que é 'gray failure' e como ele se aplica ao incidente do GitHub?
'Gray failure' ocorre quando os sistemas de monitoramento internos indicam que o sistema está saudável, mas os usuários experimentam interrupções ou problemas. No caso do GitHub, o monitoramento de salvaguarda não detectou a saturação do nó primário, levando a uma falsa sensação de estabilidade enquanto o serviço já estava degradado.
Quais são as principais mudanças que o GitHub implementará para evitar futuros incidentes?
O GitHub planeja limitar a taxa de jobs em segundo plano em bancos de dados compartilhados, adicionar pausas automáticas baseadas na carga do servidor primário e não apenas no atraso de replicação. Também haverá limites nas retentativas e a fragmentação do cluster de banco de dados para eliminar pontos únicos de falha.
Como a inteligência artificial (IA) contribui para essas instabilidades no GitHub?
O boom da IA gerou um crescimento massivo no volume de código e atividade na plataforma, como o CEVIU News noticiou em junho de 2026. Este aumento de carga coloca uma pressão sem precedentes na infraestrutura do GitHub, tornando-a mais suscetível a incidentes como o de setembro de 2026, onde falhas em componentes internos são amplificadas pela demanda crescente.
Fontes
- surfingcomplexity.blogfonte original
- Categoria
- CEVIU
- Publicado
- 21 de setembro de 2026
- Editoria
- CEVIU