
Desafios na Persistência de Respostas de IA: Tokens vs. Mensagens Completas
Aprofundamento CEVIU
Aprofundamento
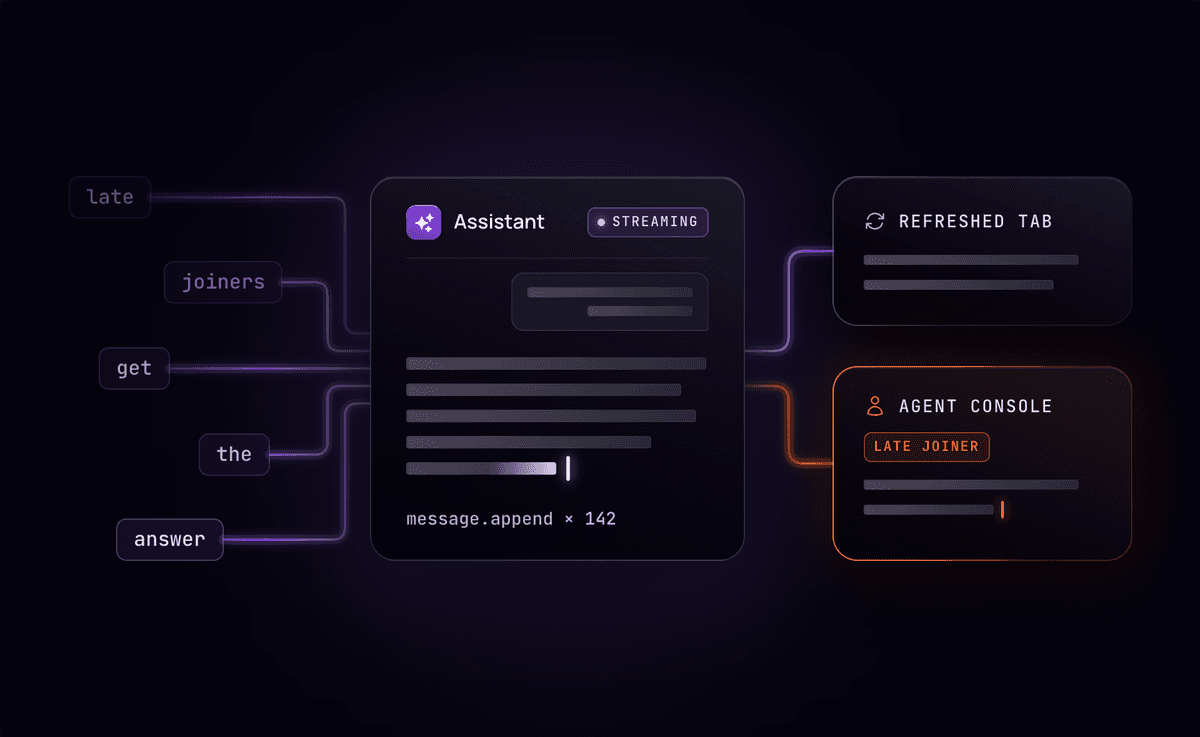
A persistência de respostas de IA é mais complexa do que parece. A maneira como se armazena o que o modelo gera afeta diretamente a experiência do usuário e a carga sobre a infraestrutura. O ponto crucial é garantir que um cliente que se conecta tardiamente, seja por uma atualização de página ou um handover de agente, consiga ver a resposta completa até aquele momento. Isso evita frustrações e custos desnecessários com novas chamadas à IA.
A análise dos padrões de armazenamento revela que a fragmentação é o grande vilão. Enquanto o envio efêmero via SSE/WebSockets e os 'chunk logs' (como Redis Streams ou NATS JetStream) entregam tokens individuais, eles falham em fornecer a resposta completa de forma coesa a um 'late joiner'. A necessidade de re-montar a mensagem no cliente ou em um serviço de projeção introduz complexidade e ineficiência. Mesmo a atualização repetida de registros em bancos de dados, como Postgres ou Firestore, embora entregue a mensagem completa, sobrecarrega o sistema com escritas excessivas por token. A solução de 'message appends' se destaca por tratar a resposta da IA como uma única mensagem que cresce, reduzindo escritas no banco de dados e simplificando a lógica do cliente.
O que mudou
A discussão sobre a persistência de respostas de IA avança significativamente com a proposta de 'message appends'. Em 24 de setembro de 2026, o CEVIU News destacou no artigo 'WebSockets se Destacam na Engenharia de Streaming de IA em Escala' a importância do transporte robusto de dados. Agora, o foco se desloca para a camada de armazenamento, mostrando que, além do transporte eficiente, a forma como os dados são organizados e acessados é vital. Antes, discutia-se a viabilidade dos logs para a reconstrução de tabelas, como abordado em 'Log-first ou Table-first: Desvendando Kafka, Fluss e Streaming Tables no Streaming de Dados' em 31 de agosto de 2026. A grande mudança é o entendimento de que para respostas de IA, persistir a *mensagem já montada* é superior a persistir *fragmentos* que exigem re-montagem constante, poupando recursos de banco de dados e simplificando o desenvolvimento.
Por que isso importa
Essa abordagem é vital para o desenvolvimento de aplicações de IA de nova geração. Ela melhora a experiência do desenvolvedor (DX) ao eliminar a complexa lógica de re-montagem de mensagens em cada cliente, permitindo que a equipe se concentre em funcionalidades centrais. Para o usuário final, significa interações mais fluidas, sem respostas perdidas ou incompletas, especialmente em cenários de reconexão ou handoff.
Além disso, a otimização da carga de I/O nos bancos de dados, ao reduzir as escritas por token para uma única escrita por resposta finalizada, significa maior escalabilidade e performance para a aplicação. Isso reflete diretamente em menor custo operacional e uma arquitetura mais resiliente, fundamental para sistemas distribuídos e de alta concorrência.
Linha do tempo
Padrões Duradouros no Design de Produtos de IA
Otimização de Custos em Aguns de IA: A Estratégia de Caching de Prompts
Desafios na Sincronização de Dados e a Proposta de um Log de Mudanças
Durabilidade de Dados e Latência: O Equilíbrio Crítico em Sistemas Distribuídos
Log-first ou Table-first: Desvendando Kafka, Fluss e Streaming Tables no Streaming de Dados
WebSockets se Destacam na Engenharia de Streaming de IA em Escala
Desafios na Persistência de Respostas de IA: Tokens vs. Mensagens Completas
Perguntas frequentes
O que significa um 'late joiner' no contexto de streaming de respostas de IA?
Um 'late joiner' é qualquer cliente que se conecta a um fluxo de resposta de IA depois que ele já começou. Isso inclui usuários que atualizam a página, dispositivos secundários, ou agentes humanos assumindo uma conversa. Para esses clientes, é crucial que consigam acessar a resposta completa da IA gerada até o momento.
Qual a principal desvantagem de persistir tokens individuais para respostas de IA?
Persistir tokens individuais como logs de eventos força os clientes (ou um serviço intermediário) a reconstruir a mensagem completa, token por token. Isso gera sobrecarga de processamento, aumenta a complexidade do código do cliente, e pode resultar em dados fragmentados ou incompletos para 'late joiners', além de sobrecarregar bancos de dados com escritas constantes.
Como a estratégia de 'message appends' otimiza a performance de bancos de dados?
Com 'message appends', o backend não reescreve a resposta no banco de dados a cada novo token. Em vez disso, ele envia pequenos 'appends' a um serviço que monta a mensagem. O banco de dados só recebe uma única escrita quando a resposta completa da IA é finalizada, reduzindo drasticamente a carga de I/O e melhorando a performance e a escalabilidade.
O CEVIU News já abordou tópicos relacionados a este antes?
Sim. Em 24 de setembro de 2026, o artigo 'WebSockets se Destacam na Engenharia de Streaming de IA em Escala' discutiu a escolha de tecnologias de transporte. O CEVIU também explorou a gestão de logs em 'Log-first ou Table-first: Desvendando Kafka, Fluss e Streaming Tables no Streaming de Dados' em 31 de agosto de 2026, e os desafios de durabilidade de dados em 'Durabilidade de Dados e Latência: O Equilíbrio Crítico em Sistemas Distribuídos' em 10 de agosto de 2026, que fornecem o contexto para a importância da persistência robusta abordada agora.
Fontes
- ably.comfonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 08 de outubro de 2026
- Editoria
- CEVIU Web Dev