
Relace Otimiza Aplicação de Edições de Código para 10.000 Tokens por Segundo
Aprofundamento CEVIU
Aprofundamento
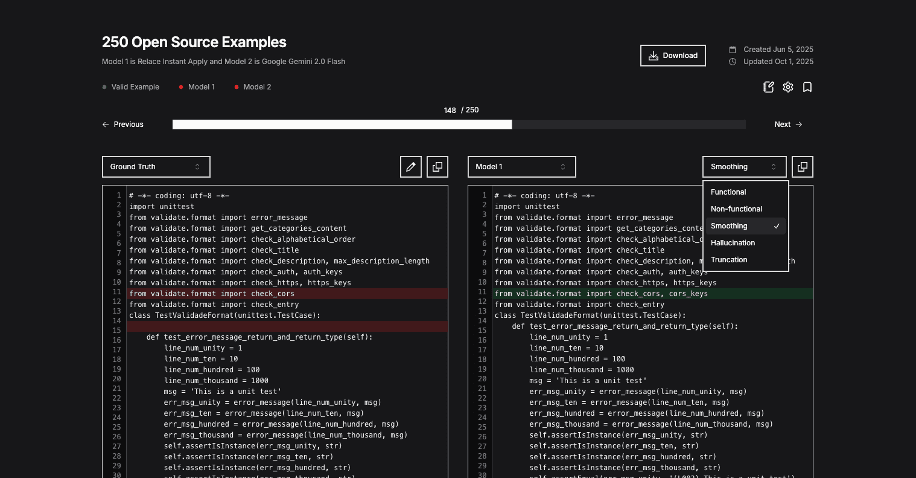
A Relace Apply 3 define um novo padrão de performance para a aplicação de edições de código, atingindo notáveis 10.000 tokens por segundo. Este avanço é crucial para o ciclo de desenvolvimento de software, especialmente em cenários com agentes de IA. A solução da Relace foca em um modelo compacto e especializado, que se distancia da abordagem tradicional de grandes LLMs regenerando o código inteiro. A chave é permitir que o LLM principal produza "lazy diffs" e usar um modelo menor para interpretar a intenção da mudança e aplicá-la, lidando com o que chamam de "diffs patológicos" que algoritmos fixos não conseguem resolver.
O processo técnico por trás dessa otimização é multifacetado. A Relace utiliza fine-tuning com LoRA, técnica que permite especializar o modelo para a tarefa de merge sem perder seu conhecimento geral de programação. A quantização FP8, combinada com os núcleos dedicados em GPUs Nvidia, otimiza o throughput. Além disso, a curadoria de dados é rigorosa: um dataset de alta qualidade de 145.000 pontos de dados, filtrado de 200.000 exemplos, garante a robustez do treinamento. Para isso, foi desenvolvido um "LLM-as-a-judge", ajustado por 500 revisões manuais, que avalia a correção das fusões e reduz a taxa de falsos positivos para 1%.
O que mudou
Nossa cobertura anterior no CEVIU já explorava a "Decodificação Especulativa" em agosto de 2026, destacando seu potencial de acelerar Large Language Models (LLMs) em até três vezes e otimizar o uso da GPU. A matéria "DFlash 2 revoluciona inferência de LLMs com decodificação especulativa aprimorada" também reforçava essa tendência. Agora, a Relace demonstra a aplicação prática e o aprimoramento dessa técnica, escalando o desempenho para 10.000 tokens por segundo em um caso de uso crítico: a aplicação de edições de código.
Este resultado representa um salto significativo em comparação com os picos de 280 tokens por segundo que observamos em otimizações mais gerais de APIs de LLMs, como na matéria "Baseten Acelera GLM-5.2 e Otimiza Latência para Aplicações de IA" de julho de 2026. A Relace prova que a decodificação especulativa, quando combinada com modelos especializados e datasets de alta qualidade, pode alcançar níveis de performance antes inatingíveis para tarefas específicas de desenvolvimento.
Por que isso importa
A performance de 10.000 tokens por segundo muda a forma como os desenvolvedores interagem com ferramentas de IA para código. Isso elimina o gargalo da aplicação de edições, que antes era demorada e custosa. Para agentes de IA, significa a capacidade de realizar modificações complexas no código-fonte em tempo quase real, sem a intervenção humana constante para corrigir erros de merge.
Este avanço também valida a estratégia de modelos especializados e otimização de infraestrutura. A Relace mostra que não é preciso um LLM gigantesco para cada etapa do pipeline. Um modelo menor e focado pode superar LLMs maiores em tarefas específicas, reduzindo custos e aumentando a eficiência. Isso tem implicações diretas na experiência do desenvolvedor, acelerando o ciclo de feedback e permitindo iterações mais rápidas no desenvolvimento de software.
Linha do tempo
Um Motor de Inference LLM na Velocidade da Luz para Workloads de Agentes
Otimização de Agentes de IA: Redução Drástica de Tokens e Tempo de Execução
Baseten Acelera GLM-5.2 e Otimiza Latência para Aplicações de IA
Otimização de GPU com IA: Fatoração QR atinge aceleração de 232x com Codex
DFlash 2 revoluciona inferência de LLMs com decodificação especulativa aprimorada
Decodificação Especulativa: O Segredo para Acelerar LLMs em até 3 Vezes
Relace Otimiza Aplicação de Edições de Código para 10.000 Tokens por Segundo
Perguntas frequentes
O que é Relace Apply 3 e qual sua principal função?
O Relace Apply 3 é um modelo especializado em aplicar edições de código de forma otimizada. Ele interpreta a intenção de um "diff" gerado por um LLM maior e o integra ao código existente, alcançando uma velocidade de 10.000 tokens por segundo.
Como o Relace Apply 3 atinge 10.000 tokens por segundo?
Ele combina várias otimizações: fine-tuning eficiente com LoRA, quantização FP8 para maximizar o throughput da GPU, e decodificação especulativa que acelera a geração de tokens ao "adivinhar" sequências de código.
Por que usar um LLM para aplicar edições de código, em vez de um algoritmo fixo?
LLMs conseguem inferir a intenção por trás de "diffs" complexos, que são difíceis para algoritmos fixos. Isso permite que o sistema lide com "diffs patológicos" e produza código correto, mesmo com edições sutis ou múltiplas.
Qual a importância da curadoria de dados e do "LLM-as-a-judge" no treinamento do modelo?
A alta qualidade do dataset é crucial para modelos menores. O "LLM-as-a-judge", ajustado manualmente, filtra exemplos de treinamento, garantindo que o modelo aprenda apenas com merges corretos e lide bem com os muitos casos de borda do mundo real.
Fontes
- relace.aifonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 15 de outubro de 2026
- Editoria
- CEVIU Web Dev