
Otimizando Decisões: Um Guia para Modelos Eficientes e Integrados
Aprofundamento CEVIU
Aprofundamento
A otimização de modelos de decisão marca uma virada importante na forma como a IA é aplicada em sistemas de software. Antes, tarefas como rotear um ticket de suporte ou pontuar uma avaliação de risco dependiam de chamadas a APIs de chat como /v1/chat/completions. Isso implicava um custo computacional significativo, a chamada “taxa de decode” para gerar tokens de texto, além da sobrecarga de parsing JSON e da incerteza nas probabilidades.
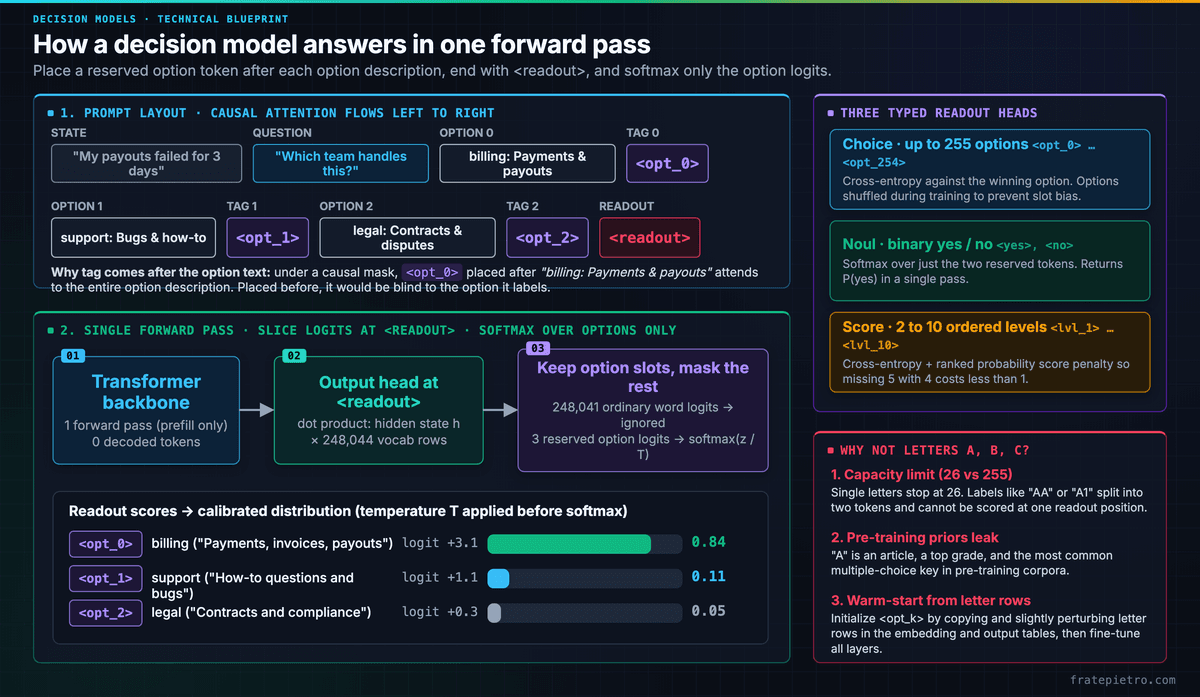
Agora, o foco migra para modelos que preveem probabilidades diretamente, eliminando a geração textual. A integração do endpoint /v1/systemone no transformers serve do Hugging Face é central. Isso permite que qualquer LLM ou VLM se torne um modelo de decisão, rodando um único forward pass e retornando distribuições de probabilidade. Técnicas como tokens de opção reservados, calibração precisa (ajustando a temperatura e usando soft training targets) e o tree batching para processar múltiplas questões sobre um mesmo contexto são fundamentais para alcançar performance e baixa latência.
O que mudou
Nossa cobertura anterior, como a matéria sobre a “Engenharia de inference para LLMs” de 16 de junho de 2026, detalhava as complexas fases de prefill e decode na inferência. A grande mudança agora é que, para modelos de decisão, podemos pular a fase de decode, que é intensiva em memória e tempo. Em vez de pagar a “taxa de decode” por dezenas de tokens de saída, esses modelos geram zero tokens de texto, focando apenas no prefill para obter probabilidades diretas.
Além disso, o que era um padrão proprietário, como visto na matéria “Jev e a Nova Geração de Classificadores” de 30 de setembro de 2026, que destacava o Jev por seus retornos tipados, agora se torna um padrão aberto. A Hugging Face integrou suporte nativo ao /v1/systemone, democratizando o acesso a essa abordagem eficiente para desenvolvedores. As “Estratégias Eficazes para Modelos 'System One'” de 21 de setembro de 2026 eram mais conceituais; hoje temos as ferramentas e métodos para implementá-las diretamente.
Por que isso importa
Para o desenvolvedor, a implementação de modelos de decisão eficientes significa uma redução drástica na latência e nos custos operacionais de sistemas que dependem de inferência de IA. Evitar a geração de texto e o parsing de JSON libera recursos computacionais, tornando aplicações mais rápidas e escaláveis. A capacidade de obter probabilidades calibradas e confiáveis diretamente do modelo melhora a precisão e a segurança das decisões automatizadas, minimizando o risco de falhas ou 'alucinações'.
Essa abordagem permite que a IA seja aplicada de forma mais direcionada em tarefas específicas, como triagem de tickets ou detecção de anomalias, garantindo que o tempo de resposta do sistema seja quase imediato. É um passo significativo para construir sistemas de software mais robustos, com melhor experiência do usuário e do desenvolvedor (DX).
Linha do tempo
CEVIU News publica 'Profiling no PyTorch (Parte 1): dominando o torch.profiler para otimizar seus modelos'.
CEVIU News publica 'Engenharia de inference para LLMs: como otimizar prefill e decode com trade-offs técnicos'.
CEVIU News publica 'Desvendando a Paralelização no Treinamento de Modelos Transformer'.
CEVIU News publica 'Estratégias Eficazes para Modelos 'System One' em Processamento de Dados'.
CEVIU News publica 'Jev e a Nova Geração de Classificadores: Otimizando Decisões com IA e Reduzindo 'Hallucinations''.
CEVIU News publica 'Decodificação Especulativa: Avançando na Geração de Conteúdo com IA'.
CEVIU News publica 'Otimizando Decisões: Um Guia para Modelos Eficientes e Integrados', detalhando a integração /v1/systemone.
Perguntas frequentes
Qual a principal vantagem dos modelos de decisão sobre LLMs generativos para certas tarefas?
A principal vantagem é a eficiência. Modelos de decisão fornecem probabilidades diretas para um conjunto conhecido de resultados, sem gerar texto. Isso elimina a latência da fase de decode e o custo de processamento de tokens desnecessários.
O que são tokens de opção reservados e por que são importantes?
Tokens de opção reservados são identificadores únicos adicionados ao vocabulário do modelo, como <opt_0>. Eles resolvem problemas de capacidade (limitação de 26 letras), prioridades pré-treinamento de tokens comuns e viés de posição, garantindo que o modelo atribua probabilidades de forma neutra e escalável.
Como a calibração de modelos afeta a confiabilidade das probabilidades?
A calibração garante que a probabilidade relatada pelo modelo, por exemplo, 0.90, realmente corresponda a 90% de chances de acerto. Técnicas como temperature scaling e soft targets corrigem o excesso ou falta de confiança do modelo, tornando suas previsões numéricas mais confiáveis para uso em lógica de aplicação.
O que é <i>tree batching</i> e como ele otimiza o processamento de múltiplas questões?
Tree batching é uma técnica que agrupa múltiplas questões sobre um mesmo documento em uma única sequência de entrada. Isso evita a duplicação do estado em cache e reduz a contenção de agendador, permitindo que o modelo responda a dezenas de perguntas com latência mínima, processando-as em um único forward pass.
Fontes
- fratepietro.comfonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 21 de outubro de 2026
- Editoria
- CEVIU Web Dev