
Como a Apple faz um LLM de 3 bilhões de parâmetros caber no iPhone
Aprofundamento CEVIU
Aprofundamento
O texto parte de dois gargalos de rodar inferência num celular: capacidade e largura de banda de memória. Com precisão de 16 bits, 3 bilhões de parâmetros ocupam quase 6GB, e ainda sobra pouco para prompt, cálculos intermediários, o sistema operacional e outros apps. Além disso, o processador gasta tempo esperando os pesos chegarem da memória, mesmo sendo rápido.
A resposta da Apple tem quatro frentes. Na quantização, usa palettization, com tabela de consulta e referências curtas por peso. A versão anterior do modelo misturava 2 e 4 bits (média de 3,7 bits por peso, cerca de 1,39 GB). A mais recente usa 2 bits no decoder principal e 4 bits na tabela de embeddings, com quantization-aware training. No KV cache, o cross-layer KV sharing divide o modelo em dois blocos na proporção 5:3 e reduz o uso de memória do cache em 37,5%. Nos adapters, LoRA permite uma base compartilhada com adapters de rank 16 em 16 bits, de dezenas de MBs, que podem ser carregados, cacheados ou trocados. Por fim, o roteamento: pedidos mais complexos vão para o Private Cloud Compute (PCC), com requisição criptografada para nós validados.
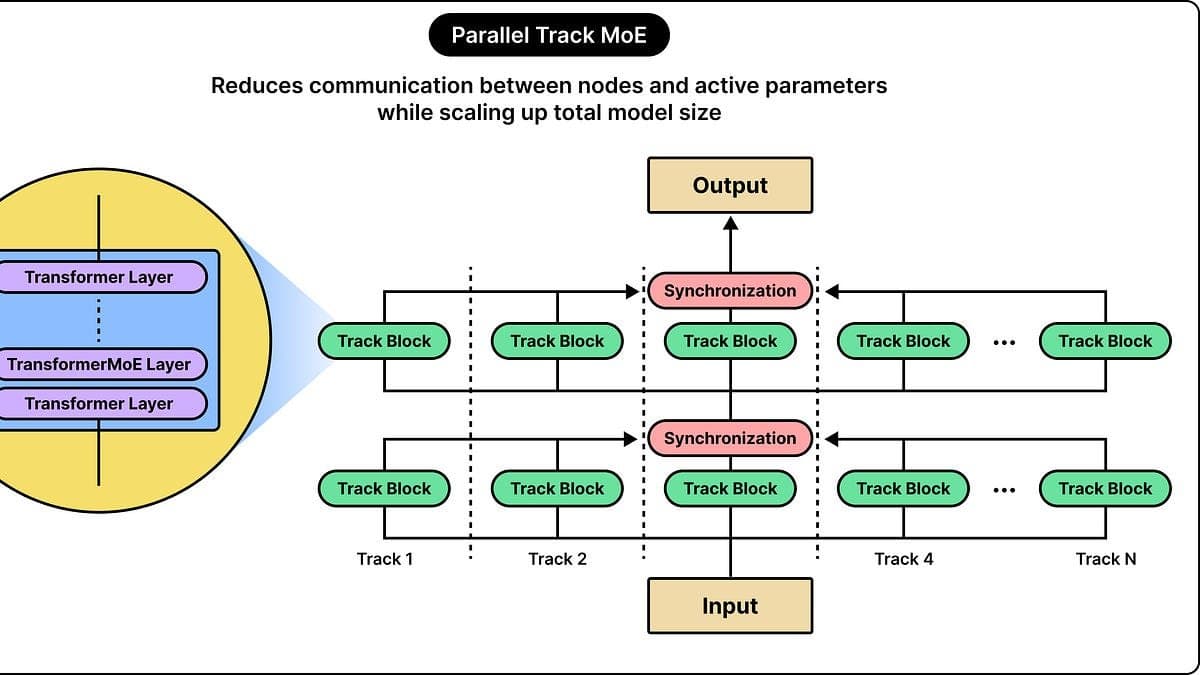
O texto também cita novidades de 2026: o AFM 3 Core, nova geração do modelo de 3 bilhões, e o AFM 3 Core Advanced, esparso, com 20 bilhões de parâmetros totais e 1 a 4 bilhões ativos por vez. Nele, o modelo fica em flash e só os pesos dos experts vão para a RAM. O PCC também passou a rodar cargas em GPUs NVIDIA no Google Cloud.
O que mudou
A cobertura do CEVIU mostra a Apple perseguindo IA local cada vez maior. Em 29 de maio de 2026, o CEVIU noticiou "Apple busca integrar modelo Gemini massivo em iPhones para impulsionar nova Siri", com model distillation e nuvem híbrida. Em 11 de julho de 2026, veio "Apple negocia para rodar IA gigante diretamente nos iPhones", sobre conversas com a PrismML e a demonstração do Qwen 3.6 de 27 bilhões de parâmetros. Em 2 de setembro de 2026, o CEVIU publicou "Apple Impulsiona IA On-Device com Novo Motor Lily para LLMs em Apple Silicon". Agora a matéria detalha as técnicas do modelo próprio de 3 bilhões. Os textos anteriores não ligam essas técnicas a negociações ou ao motor Lily, então não dá afirmar relação entre eles.
Por que isso importa
Para quem desenvolve apps ou features com IA no iPhone, a leitura é que o orçamento de memória define o desenho do produto. Um modelo base compartilhado com adapters por tarefa evita duplicar pesos, e a decisão entre rodar local ou no PCC passa a ser parte da arquitetura. É uma interpretação, não algo dito pela fonte.
Linha do tempo
CEVIU noticia a Apple buscando integrar o Gemini à Siri com model distillation e nuvem híbrida.
CEVIU noticia negociações da Apple com a PrismML para rodar IA grande nos iPhones.
CEVIU noticia o motor Lily para inferência de LLMs em Apple Silicon.
CEVIU explica como a Apple encaixa um LLM de 3 bilhões de parâmetros no iPhone.
Perguntas frequentes
Como um modelo de 3 bilhões de parâmetros cabe no iPhone?
A Apple comprime os pesos com palettization e quantization-aware training. A versão anterior usava média de 3,7 bits por peso, cerca de 1,39 GB. A mais recente usa 2 bits no decoder principal e 4 bits nos embeddings.
O que é o cross-layer KV sharing?
É uma técnica que divide o modelo em dois blocos, com proporção de profundidade 5:3. As camadas do segundo bloco reutilizam chaves e valores da última camada do primeiro. Com isso, a Apple reduziu o uso de memória do KV cache em 37,5%.
Para que servem os adapters LoRA no modelo da Apple?
Eles especializam o mesmo modelo base para tarefas como resumo de notificações ou reescrita de texto. Só os pesos do adapter são treinados, com a base congelada. Os adapters de rank 16 ocupam dezenas de MBs e podem ser carregados ou trocados.
Quando o iPhone envia a requisição para a nuvem?
O Apple Intelligence verifica se o pedido pode ser processado no aparelho. Tarefas como resumo, extração e classificação ficam locais. Trabalhos mais complexos podem ir para o Private Cloud Compute, com requisição criptografada para nós validados.
Fontes
- blog.bytebytego.comfonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 28 de outubro de 2026
- Editoria
- CEVIU Web Dev