
Otimização de Memória Reduz Custos e Aumenta Eficiência em Agentes de IA
Aprofundamento CEVIU
Aprofundamento
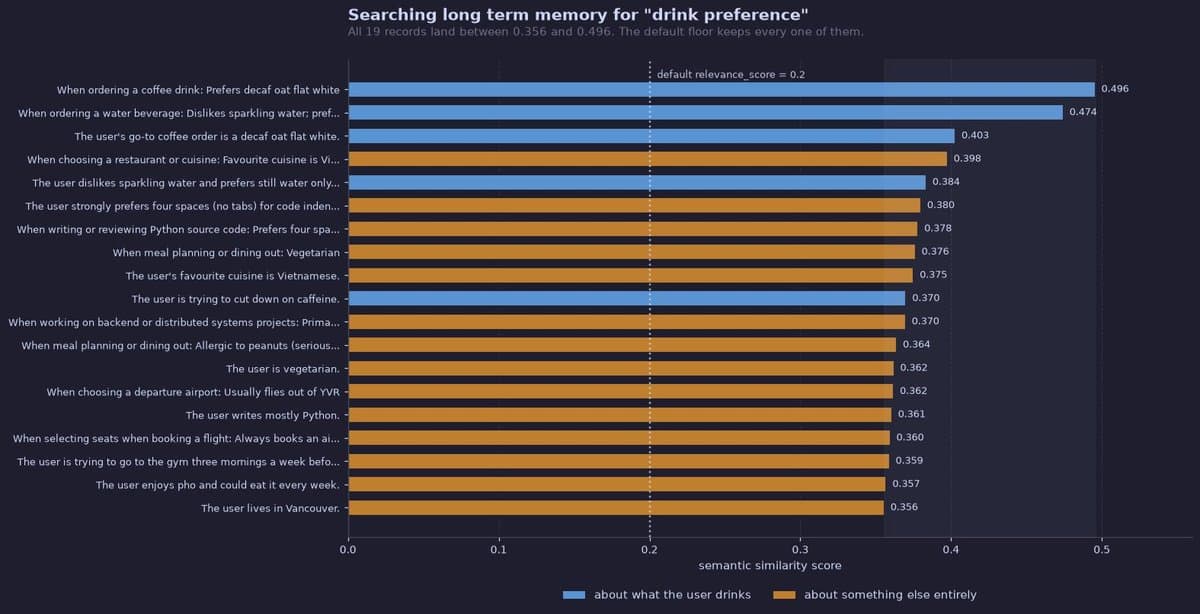
A otimização da memória em agentes de IA avança com a adoção de modelos de decisão estratégicos. Estes modelos atuam como "porteiros" inteligentes, determinando a necessidade e a relevância da recuperação de informações da memória de longo prazo. O foco é na recuperação sob demanda, eliminando a injeção desnecessária de contexto que sobrecarrega os modelos de linguagem grandes (LLMs) e eleva os custos operacionais.
Um exemplo prático dessa abordagem, utilizando um classificador estratégico como o strands-decider (um modelo de decisão de código aberto de 2 bilhões de parâmetros), demonstrou uma redução impressionante de 85% no contexto injetado. Além disso, foram eliminadas cinco das oito chamadas de memória, tudo isso mantendo a precisão das respostas. Esta técnica representa um ganho substancial em eficiência operacional e um controle mais refinado sobre o consumo de tokens, que se traduz diretamente em menor custo e maior desempenho para as implementações de IA em escala empresarial.
O que mudou
Nossa cobertura anterior já vinha explorando diversas frentes para a otimização de IA, focando na redução de tokens e no gerenciamento de contexto. Em 11 de julho de 2026, por exemplo, discutimos como LLMs compactos aprimoravam o RAG ao otimizar o contexto com precisão. Matérias de 15, 20 e 30 de julho de 2026 também detalharam métodos para reduzir o consumo de tokens e melhorar a eficiência dos agentes.
A novidade agora é a introdução de um modelo de decisão dedicado, como o strands-decider, que atua como um gate estratégico antes mesmo da recuperação de memória. Em vez de apenas otimizar o que já foi recuperado ou compilar tarefas para economizar tokens, a abordagem atual foca em decidir de forma inteligente *se* e *o quê* deve ser recuperado em primeiro lugar. Isso confere um nível proativo de controle sobre o fluxo de informações, representando um salto na governança e na eficiência da interação dos agentes com seus repositórios de memória de longo prazo.
Por que isso importa
Para líderes de TI e arquitetos de soluções em nuvem, esta inovação é um marco estratégico. A capacidade de reduzir o contexto injetado e as chamadas de memória em até 85% impacta diretamente o TCO (Custo Total de Propriedade) das soluções de IA. Menos tokens processados significam menos custos de API e infraestrutura, além de uma melhor utilização dos recursos de computação, especialmente em ambientes de nuvem.
Além da economia, a otimização eleva a performance dos agentes de IA, com respostas mais rápidas e precisas. Isso é crucial para aplicações que exigem baixa latência e alta escalabilidade. Aprimora-se a governança de IA, garantindo que os agentes acessem apenas informações estritamente necessárias, mitigando riscos e promovendo uma transformação digital mais inteligente e sustentável.
Linha do tempo
LLM Compacto Aprimora RAG e Otimiza Contexto com Alta Precisão
Redução de 94% no Uso de Tokens Otimiza Agentes por Meio de Compilação de Habilidades
Otimização de Agentes de IA: Redução Drástica de Tokens e Tempo de Execução
Otimização de Custos em Aguns de IA: A Estratégia de Caching de Prompts
Deep Agents v0.7 revoluciona eficiência de tokens, mantendo performance da IA
Otimização Revolucionária na Inferência de LLMs Reduz Custos e Impulsiona a Eficiência da IA
Otimização de Memória Reduz Custos e Aumenta Eficiência em Agentes de IA
Perguntas frequentes
Qual o principal problema que a otimização de memória resolve em agentes de IA?
Agentes de IA frequentemente recuperam e processam grandes volumes de informações desnecessárias da memória de longo prazo. Isso aumenta o consumo de tokens, eleva os custos operacionais e prejudica a performance, tornando as operações mais lentas e caras.
Como os novos modelos de decisão, como o strands-decider, funcionam nesta otimização?
Estes modelos atuam como "gates" ou porteiros inteligentes. Eles decidem, de forma rápida e eficiente, se uma recuperação de memória é realmente necessária e quais informações são relevantes para a tarefa atual do agente, antes mesmo de injetar contexto desnecessário no LLM principal.
Quais os benefícios práticos para as empresas que implementam essa otimização?
As empresas podem esperar uma redução significativa nos custos operacionais, devido ao menor consumo de tokens. Há também um aumento na eficiência e na velocidade de resposta dos agentes de IA, além de uma melhor governança sobre o fluxo de informações, resultando em uma IA mais econômica e performática.
Essa abordagem pode ser integrada com as plataformas de IA existentes?
Sim, a integração com plataformas existentes, como o AgentCore Memory do Amazon Bedrock, já foi demonstrada. Isso mostra a viabilidade de aplicar essa técnica em ecossistemas de IA empresariais, potencializando as capacidades dos agentes sem a necessidade de reengenharia completa.
Fontes
- blog.mikegchambers.comfonte original
- Categoria
- CEVIU TI
- Publicado
- 09 de outubro de 2026
- Editoria
- CEVIU TI