
Estratégias de IA: Tiger Data Repensa a Gestão da Memória de Agentes
Aprofundamento CEVIU
Aprofundamento
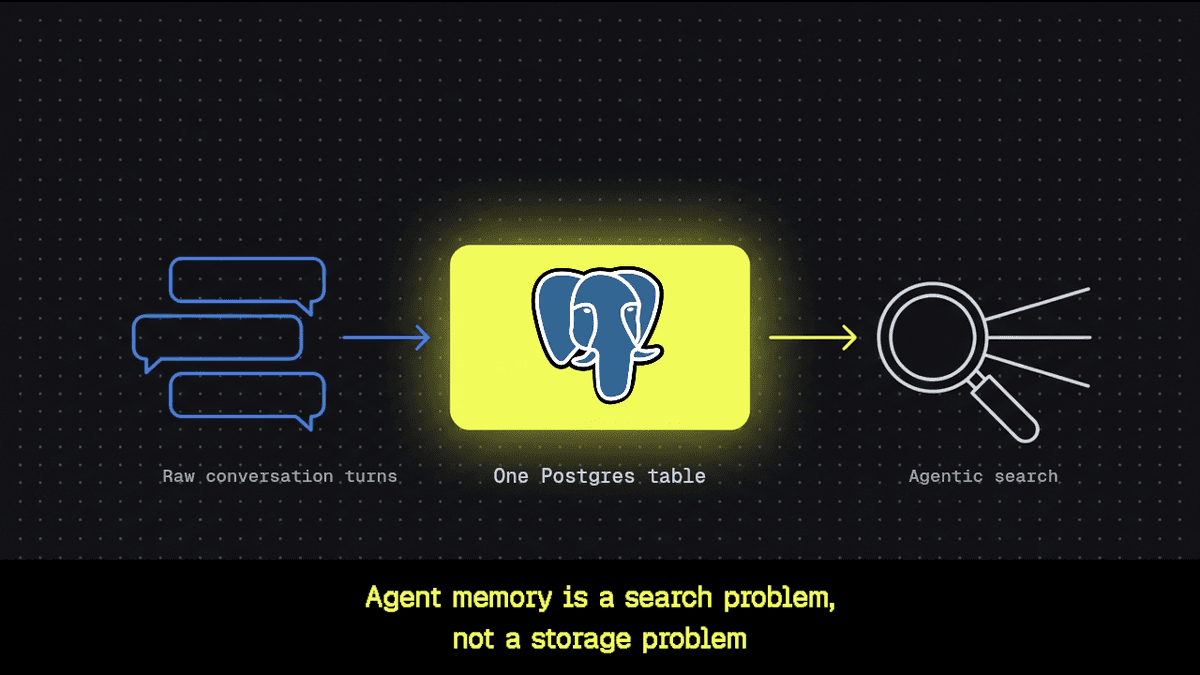
A Tiger Data está questionando paradigmas estabelecidos na gestão de memória para agentes de IA. A empresa adota uma abordagem minimalista e foca em capacitar o próprio agente para buscar informações, em vez de depender de pré-processamento complexo. A estratégia envolve armazenar interações de conversação cruas em uma única tabela do PostgreSQL, expondo ferramentas de busca específicas para que o agente decida como e o que consultar. Esta simplificação se mostrou mais eficaz em testes, superando métodos tradicionais que empregam extração de fatos, grafos de conhecimento e sumarização de sessões, com um F1 de 0.665 no benchmark LoCoMo usando Claude Sonnet, em comparação com 0.613 do Omni-SimpleMem.
Tecnicamente, a Tiger Data utiliza PostgreSQL com pgvector para busca vetorial, pg_textsearch para busca de texto completo e ltree para hierarquias. As incorporações (embeddings) vêm do OpenAI text-embedding-3-small, sem chamadas de LLM durante a ingestão de dados. O coração do sistema não está em um pipeline de recuperação fixo, mas na capacidade do agente de adaptar sua estratégia de busca por meio de ferramentas e um prompt de sistema bem definido. Isso otimiza o uso de ferramentas, evita o custo de processamento desnecessário e melhora a precisão, realçando que a qualidade dos resultados reside na interface da ferramenta e na capacidade do agente de se autorregular, e não na complexidade da infraestrutura de memória.
O que mudou
A abordagem da Tiger Data marca uma mudança notável em relação a discussões anteriores na comunidade de IA e na própria cobertura do CEVIU News. Em abril de 2026, um artigo alertava: "Não Trate a Memória de IA Como um Problema de Busca". Aquela análise defendia que a memória de IA exigia gerenciamento ativo de decaimento, contradição e confiança, com um design baseado em SQLite para essas funcionalidades. A Tiger Data, no entanto, argumenta e demonstra numericamente que, com as ferramentas e prompts certos, a memória pode e deve ser tratada como um problema de busca eficaz, diretamente pelo agente.
Além disso, enquanto o CEVIU News destacou o formato Memoryfields em setembro de 2026 como um padrão simplificado de armazenamento (Markdown com metadados YAML e índice vetorial SQLite), a Tiger Data vai além da padronização de formato. Ela prova que a complexidade da gestão da memória não precisa residir nem em um formato especializado, nem em camadas de pré-processamento, mas sim na inteligência do agente para navegar em dados brutos. A empresa desmistifica a necessidade de extração de fatos, sumarização e grafos de conhecimento, elementos considerados essenciais em muitos dos sistemas anteriores.
Por que isso importa
Para empresas, a simplificação da arquitetura de memória proposta pela Tiger Data é um divisor de águas. Ao eliminar a necessidade de extração de fatos e outros pré-processamentos, os custos de ingestão de dados e a complexidade operacional diminuem significativamente. Isso permite que equipes de TI e arquitetos de sistemas implementem agentes de IA de longo prazo com maior agilidade e menor sobrecarga, sem comprometer o desempenho.
A ênfase na capacidade do agente de autogerenciar sua busca e na importância de um design de ferramentas simples redefine a estratégia de desenvolvimento. O foco muda da construção de pipelines de dados complexos para a engenharia de prompts e interfaces de ferramentas intuitivas. A preocupação com a "rejeição adversária" (a capacidade do agente de se recusar a responder quando não há dados fundamentados) também é crucial para a governança e a segurança da informação, assegurando que os sistemas de IA corporativos sejam confiáveis e evitem alucinações. Este modelo aponta para uma era de agentes de IA mais eficientes, autônomos e mais fáceis de escalar.
Linha do tempo
CEVIU News publica "Não Trate a Memória de IA Como um Problema de Busca"
CEVIU News reporta sobre nova memória proativa para agentes autônomos
CEVIU News cobre caso de agente de IA substituindo o Notion em SaaS
CEVIU News discute a longevidade ideal para agentes de IA
CEVIU News apresenta o "Memoryfields" como novo padrão de memória de IA
CEVIU News detalha o "Memoryfields" como formato portátil de arquivo
Tiger Data repensa a gestão da memória de agentes de IA
Perguntas frequentes
Qual é a principal inovação da Tiger Data na gestão da memória de IA?
A Tiger Data inova ao tratar a memória de agentes de IA como um problema de busca, e não de armazenamento pré-processado. Eles usam o próprio agente para buscar informações em dados brutos de conversação, dispensando extração de fatos, sumarização e grafos de conhecimento.
Por que a Tiger Data evita a extração de fatos e grafos de conhecimento?
A empresa constatou que esses métodos tradicionais não melhoram o desempenho (F1) e, na verdade, aumentam significativamente o tempo de ingestão de dados. Eles argumentam que a capacidade dos LLMs de usar ferramentas de busca torna essas camadas de pré-processamento desnecessárias.
Qual é a relevância do benchmark LoCoMo para esta abordagem?
O benchmark LoCoMo avalia a memória conversacional de longo prazo dos agentes de IA. A solução da Tiger Data obteve pontuações superiores a métodos concorrentes nesse benchmark, validando a eficácia de sua estratégia simplificada e baseada em busca.
Como esta abordagem impacta o design de agentes de IA para empresas?
Essa metodologia simplifica drasticamente a arquitetura de agentes de IA, reduzindo custos de ingestão e a complexidade de desenvolvimento. As empresas podem focar mais em prompts e design de ferramentas, resultando em agentes mais ágeis, confiáveis e escaláveis para aplicações corporativas.
Fontes
- tigerdata.comfonte original
- Categoria
- CEVIU TI
- Publicado
- 30 de setembro de 2026
- Editoria
- CEVIU TI