
A base da confiança em produtos de IA: Avaliações e Orquestração
Aprofundamento CEVIU
Aprofundamento
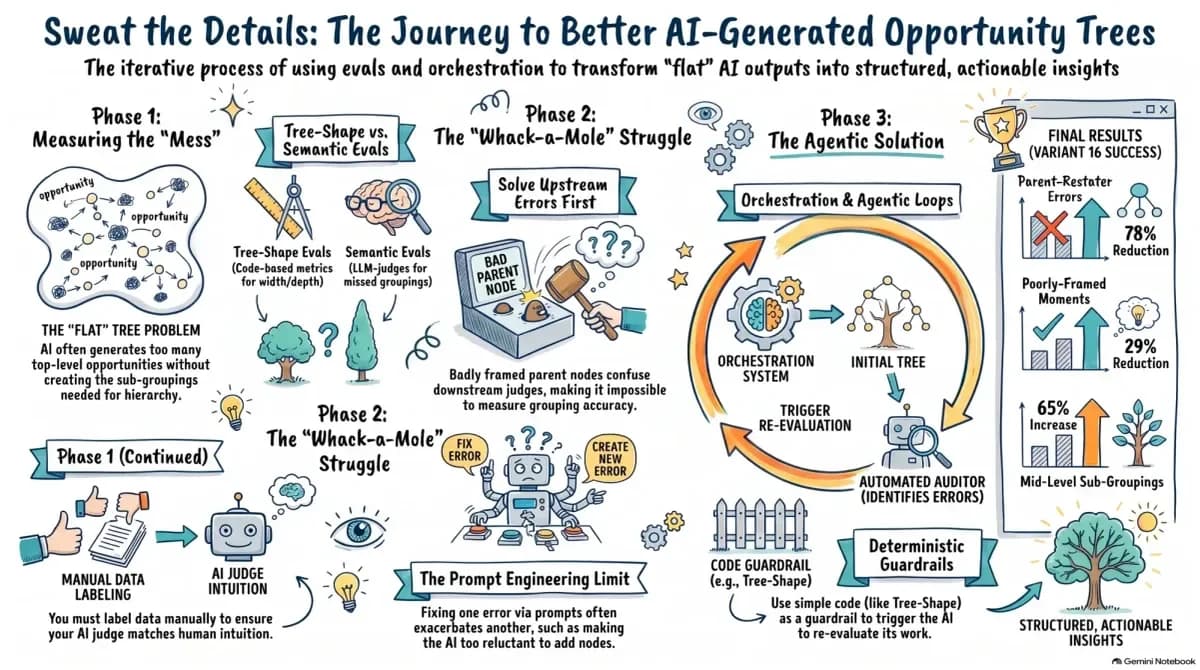
Construir produtos de IA confiáveis exige mais do que apenas refinar prompts ou modelos. É fundamental estabelecer um ciclo de validação contínuo, focado na descoberta profunda dos problemas do usuário e na medição rigorosa da qualidade. O caso da Vistaly ilustra bem isso: uma reclamação inicial do cliente sobre a estrutura de uma árvore de oportunidades gerada por IA levou a uma investigação complexa, que demandou a criação de quatro novas avaliações (evals) e 16 variações experimentais para chegar à causa-raiz do problema.
Para um Product Manager, isso significa ir além da observação superficial. É preciso usar ferramentas como os AI evals para quantificar erros, sejam eles de forma (code-assertion evals) ou semânticos (LLM-as-a-Judge evals). A calibração dessas avaliações é vital para garantir que os resultados reflitam a realidade do usuário e para identificar problemas
Linha do tempo
CEVIU News destaca a necessidade de pontuação de confiabilidade para agentes de IA antes de produção.
CEVIU News aborda a importância do contexto dos produtos de dados para IA corporativa.
CEVIU News aponta que agentes de IA em produção exigem APIs robustas e dados confiáveis, não só modelos inteligentes.
CEVIU News enfatiza a estrutura organizacional como pilar fundamental para produtos digitais na era da IA.
CEVIU News discute aprimoramento de loops de agentes autônomos com abordagem estruturada.
CEVIU News explora a depuração essencial para desvendar falhas e garantir respostas precisas em agentes de IA.
CEVIU News detalha o papel das avaliações e orquestração na construção da confiança em produtos de IA.
Perguntas frequentes
O que são 'AI evals' e por que são importantes?
AI evals são métricas usadas para medir a frequência de erros ou a qualidade das saídas de um modelo de IA. São cruciais para avaliar a correção das respostas de um LLM, permitindo que as equipes de produto identifiquem e corrijam falhas de forma sistemática.
Qual a diferença entre um <em>code-assertion eval</em> e um <em>LLM-as-a-Judge eval</em>?
Um code-assertion eval mede aspectos quantificáveis da saída de uma IA, como a estrutura ou a contagem de elementos. Já um LLM-as-a-Judge eval utiliza um segundo LLM para avaliar a saída do primeiro LLM, focando em tarefas semânticas ou subjetivas, como a detecção de agrupamentos perdidos ou a coerência de texto.
Por que é importante 'calibrar' um <em>LLM-as-a-Judge eval</em>?
A calibração é essencial para garantir que o LLM-as-a-Judge avalie o output da IA de forma alinhada com o julgamento humano. Sem isso, o avaliador de IA pode gerar muitos falsos positivos ou negativos, levando a conclusões imprecisas sobre a performance do sistema.
O que são 'erros upstream' no contexto de produtos de IA?
Erros upstream são falhas que ocorrem em etapas anteriores do pipeline de geração de IA, como a formatação inadequada de dados de entrada ou a criação de conceitos-chave mal definidos. Corrigir esses erros logo no início do processo melhora a performance de avaliações posteriores e a qualidade final do produto.
Fontes
- producttalk.orgfonte original
- Categoria
- CEVIU Gestão de Produtos
- Publicado
- 18 de setembro de 2026
- Editoria
- CEVIU Gestão de Produtos