
Na camada de apps de IA, o valor tende a ficar com quem detém dados que os laboratórios não replicam
Aprofundamento CEVIU
Aprofundamento
A tese vem da Euclid, gestora que organizou o Verticalist Summit em San Francisco, em 23 de setembro. O gatilho foram dois fatos com uma semana de diferença: a Harvey levantou nova rodada a US$ 15,5 bilhões de valuation pós-money, pouco depois de lançar o Tenet, modelo jurídico próprio treinado sobre pesos abertos, e a OpenAI lançou o Astra for Law. Dois players bem capitalizados, com modelos próprios, atrás dos mesmos advogados.
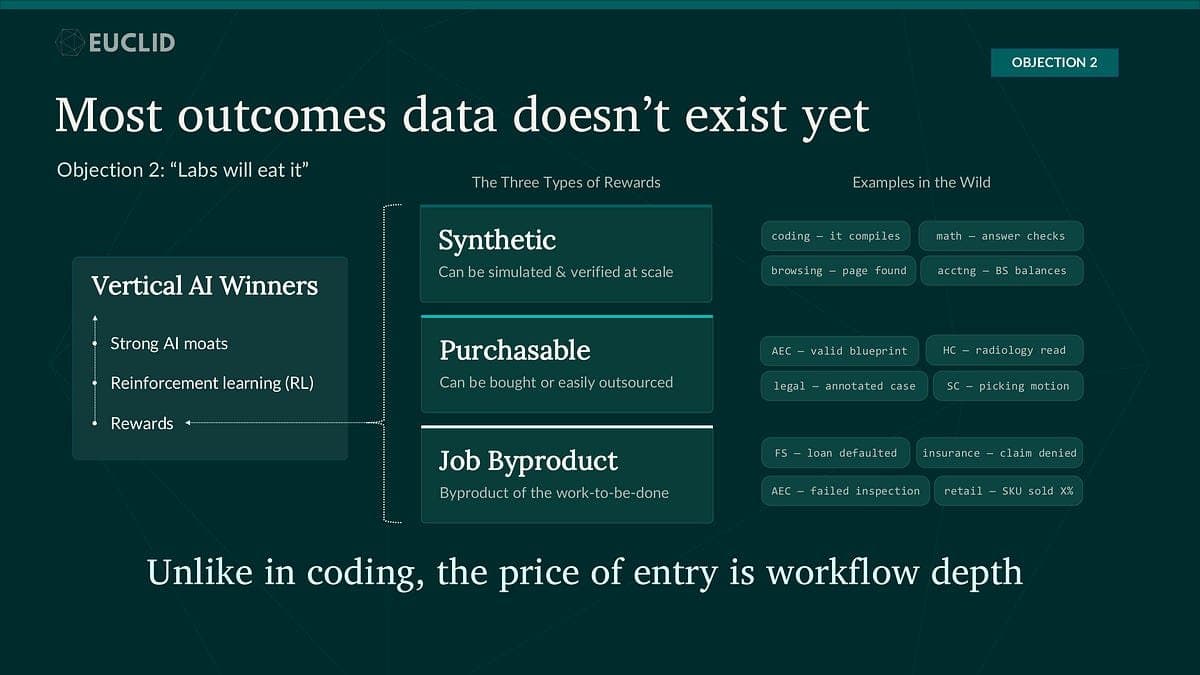
O argumento central separa os resultados que alimentam o aprendizado por reforço em três grupos. Sintéticos são os simulados e verificados em escala (código compila). Comprináveis são os que se contratam, como jurisprudência anotada ou laudos de radiologia. Subprodutos do trabalho só existem quando alguém executa a tarefa: o empréstimo entrou em inadimplência, o sinistro foi aprovado, a obra passou na vistoria. Coding decolou por estar no primeiro grupo. A Euclid sustenta que o dado mais valioso não pode ser simulado nem comprado, e que a entrada exige profundidade no fluxo de trabalho. A heurística prática: liste cada resultado que seu produto toca e classifique. Se a maioria é sintética ou comprável, você está na raia dos laboratórios e velocidade é a única defesa. Se são subprodutos, esteja presente quando o resultado acontece e capture-o como dado estruturado desde o primeiro dia.
O que mudou
A ideia não é nova na cobertura do CEVIU. Em 29 de maio de 2026, em "Aplicações de IA não estão mortas, mas os wrappers finos sim", o CEVIU noticiou que startups ainda podem se destacar em fluxos verticais complexos e que as mais fortes possuiriam o sistema de trabalho completo. Em 19 de junho de 2026, em "O valor real do software hoje não está no código, mas nas decisões humanas que ele amplifica", o foco já estava nos dados gerados por decisões e correções humanas. Em 11 de julho de 2026 e em 25 de agosto de 2026, os textos sobre dados próprios como diferencial tratavam o tema de forma geral. A novidade agora é a taxonomia (sintético, comprável, subproduto do trabalho) e o caso concreto: o lançamento da OpenAI para advogados, uma semana após a rodada da Harvey, mostra o movimento dos laboratórios que antes era só previsão.
Por que isso importa
Para quem funda uma startup de IA vertical, a leitura é que a pergunta deixa de ser "os laboratórios vão entrar no meu mercado?" e passa a ser "que dado só eu gero?". Isso afeta decisões de produto: instrumentar o fluxo para registrar desfechos, e não só entregar a resposta do modelo. Para quem pensa em captação, o teste da Euclid vira um roteiro para explicar defensibilidade a investidores. É uma tese de uma gestora que se declara enviesada, então vale confrontá-la com o seu caso.
Linha do tempo
CEVIU publica "O Software Não Morreu. O Que Tem Valor Está Mudando", sobre valor migrando para sistemas que capturam dados.
CEVIU publica sobre wrappers finos e fluxos de trabalho verticais completos.
CEVIU publica sobre o valor das decisões humanas e dos dados que elas geram.
CEVIU publica "Dados como diferencial competitivo em produtos de IA".
CEVIU publica "Dados Próprios: O Novo Diferencial Competitivo Essencial no SaaS Pós-IA".
CEVIU publica "As novas regras da IA vertical, segundo Keith Rabois".
Euclid divulga a palestra sobre onde o valor se acumula na camada de apps de IA, com a heurística dos três tipos de resultado.
Perguntas frequentes
O que são dados de subproduto do trabalho?
São dados que só existem quando alguém executa a tarefa real. Exemplos citados: se um empréstimo entrou em inadimplência, se um sinistro foi aprovado, se uma obra passou na vistoria ou se um produto vendeu. Laboratórios não conseguem simular nem comprar esse tipo de resultado.
Por que o coding avançou mais rápido que outras áreas?
Porque o resultado é verificável automaticamente: o código compila ou não. Isso permite aos laboratórios gerar recompensas sintéticas em escala para o aprendizado por reforço, sem depender de dados externos.
Como testar se meu produto está na raia dos laboratórios?
Liste todos os resultados que o produto toca e classifique cada um como sintético, comprável ou subproduto do trabalho. Se a maioria for sintética ou comprável, a velocidade é sua principal defesa. Se forem subprodutos, o caminho é capturá-los como dados estruturados desde o primeiro dia.
Começar como wrapper é um problema?
Segundo a Euclid, não necessariamente. OpenEvidence e Harvey começaram assim e usaram a distribuição conquistada para criar lock-in e novas funções. O risco é o perma-wrapper, que só faz inferência, não tem caminho para dominar o espaço e compete com quem lhe vende o modelo.
Fontes
- insights.euclid.vcfonte original
- Categoria
- CEVIU Empreendedores
- Publicado
- 04 de novembro de 2026
- Editoria
- CEVIU Empreendedores