
Together AI Lança Together Compiler com Ganhos de Performance de 28% em GPUs
Aprofundamento CEVIU
Aprofundamento
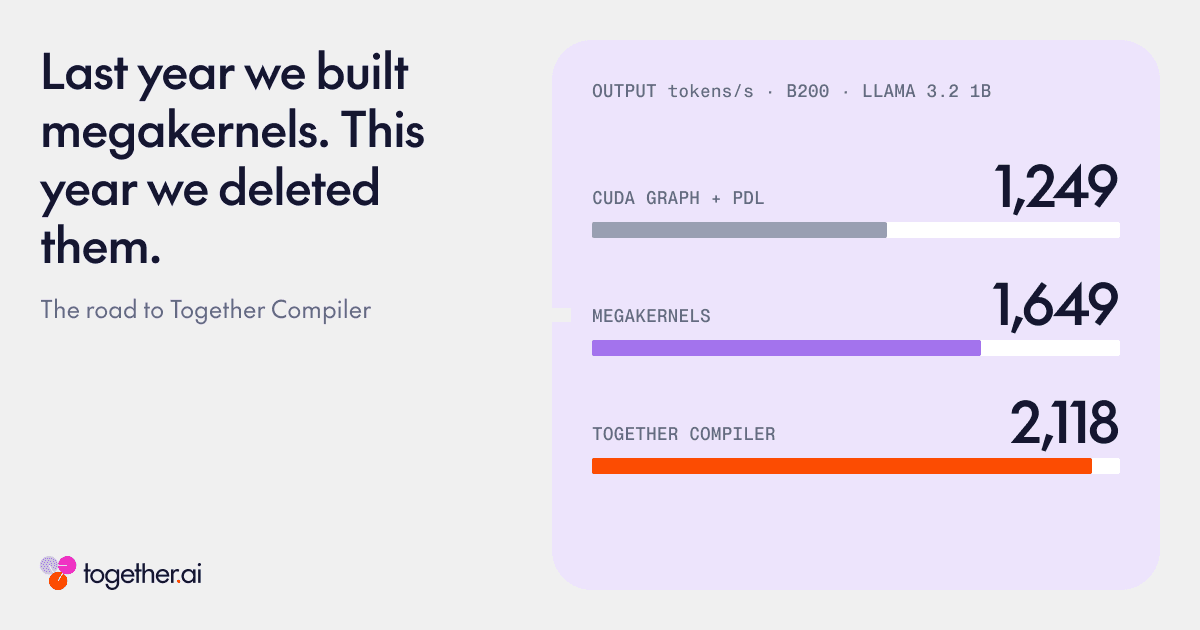
A Together AI lançou o Together Compiler, uma solução que usa agentes de IA para otimizar e consolidar kernels de GPU, prometendo ganhos de performance de até 28% em relação aos megakernels desenvolvidos manualmente pela própria empresa. A tecnologia alcançou 2.118 tokens por segundo com o Llama 3.2 1B no B200, superando os 1.649 tokens por segundo dos megakernels. A empresa destaca que a implementação de CUDA Graphs em kernels Inductor padrão já recuperava cerca de 98% do desempenho dos megakernels, mostrando a busca contínua por otimização.
O Together Compiler aborda limitações de compiladores tradicionais como o Torch Compile, que usa heurísticas locais para fusão de operações e pode deixar performance na mesa. A Together AI identificou que as heurísticas do Torch Compile nem sempre selecionam a melhor implementação para diferentes cargas de trabalho, que o benchmarking isolado pode ser impreciso por ignorar o cache da GPU e que o algoritmo de fusão pode perder oportunidades ao não considerar a utilização da GPU. O Together Compiler busca superar esses desafios com uma abordagem mais dinâmica e orientada por agentes de IA.
O que mudou
A Together AI evoluiu sua abordagem de otimização de inferência. Anteriormente, a empresa investiu em megakernels, que executavam um passe completo do modelo em um único kernel de GPU para alcançar altas velocidades. No entanto, como o CEVIU noticiou em 9 de setembro de 2026, em "Cohere Inova com Megakernel para Otimizar Inferência em GPUs, Superando Desempenho do vLLM", e também em "Cohere revela megakernel de inferência para o North Mini Code, superando vLLM em desempenho", a técnica de megakernels, embora poderosa, era difícil de colocar em produção, sendo limitada a um modelo, um tamanho de batch e um cliente. Com o Together Compiler, a empresa busca automatizar a performance dos megakernels com menos complexidade, usando agentes de IA para otimizar e consolidar kernels, superando o desempenho dos megakernels manuais e tornando a otimização mais adaptável e produtiva.
Por que isso importa
Para engenheiros DevOps e de plataforma, o Together Compiler significa uma otimização de inferência de IA mais eficiente e adaptável. A capacidade de superar megakernels manuais com uma solução automatizada reduz a complexidade de manutenção e o tempo de engenharia. Isso se traduz em melhor throughput e menor latência para modelos de IA em produção, impactando diretamente a eficiência operacional e o custo de infraestrutura. A abordagem de agentes de IA para otimização também sugere um sistema mais resiliente a mudanças de arquitetura de modelo e hardware, um ponto crítico em ambientes de IA que evoluem rapidamente.
Linha do tempo
Cohere Inova com Megakernel para Otimizar Inferência em GPUs, Superando Desempenho do vLLM
Cohere revela megakernel de inferência para o North Mini Code, superando vLLM em desempenho
Together AI Lança Together Compiler com Ganhos de Performance de 28% em GPUs
Perguntas frequentes
O que é o Together Compiler?
É uma solução da Together AI que usa agentes de IA para otimizar e consolidar kernels de GPU, visando melhorar a performance da inferência de modelos de IA. Ele busca superar as limitações de compiladores tradicionais e a complexidade dos megakernels manuais.
Qual a principal vantagem do Together Compiler em relação aos megakernels?
A principal vantagem é a automação e a adaptabilidade. Enquanto os megakernels manuais eram difíceis de colocar em produção e limitados a cenários específicos, o Together Compiler oferece ganhos de performance superiores (até 28%) de forma mais flexível e com menor esforço de engenharia.
Como o Together Compiler melhora o desempenho em relação ao Torch Compile?
Ele aborda as deficiências do Torch Compile, como heurísticas de fusão que deixam performance na mesa, benchmarking impreciso que ignora o cache da GPU e algoritmos de fusão que não consideram a utilização total da GPU. O Together Compiler usa uma abordagem mais inteligente e orientada por agentes para otimizar a execução dos kernels.
Fontes
- together.aifonte original
- Categoria
- CEVIU DevOps
- Publicado
- 20 de novembro de 2026
- Editoria
- CEVIU DevOps