
Como escalar GitOps com promoção de releases em etapas
Aprofundamento CEVIU
Aprofundamento
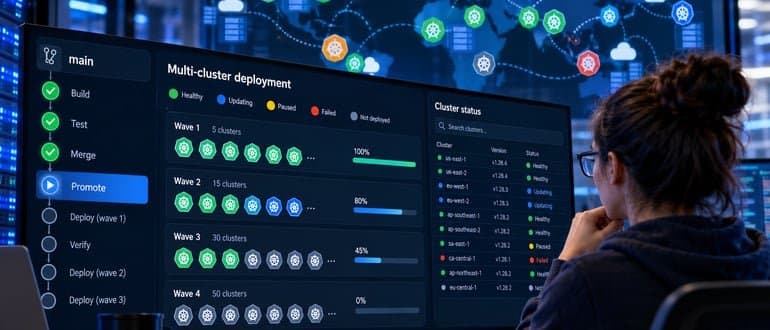
O relato de Jesse Suen, da Akuity, parte de um caso concreto: um engenheiro de plataforma responsável por uma frota de ambientes dedicados (single-tenant) em várias nuvens, com mais de 200 clusters de produção. O setup era o convencional: merge na branch principal e sync em todos os lugares. Sem nenhum gate entre o merge e a frota inteira. Toda a proteção dependia de um único ambiente réplica, e validar uma release lá levava semanas. Depois de disparada, a propagação levava cerca de uma hora.
O ponto técnico é que CI e controlador GitOps não decidem quando a release pode avançar para o próximo grupo de clusters. Suen cita ApplicationSet Progressive Syncs, rollout partitions do Rancher Fleet e as estratégias progressivas de ManifestWorkReplicaSet do OCM como ferramentas que já fazem ondas e pausam quando clusters ficam não saudáveis. O que falta, segundo ele, é rastrear uma release específica, guardar os resultados de verificação e definir para onde ela pode ir depois. A recomendação prática: escolher um grupo pequeno para ir primeiro, definir o que precisa passar antes da onda seguinte e testar se uma verificação falha de fato interrompe a propagação.
O que mudou
O tema já aparecia na cobertura do CEVIU. Em 27 de fevereiro de 2026, a matéria "Como escalar GitOps em empresas: Do cluster único à gestão de frotas" apontava gargalos e dispersão de configurações a partir de 20 a 50 clusters. Em 14 de agosto de 2026, "Octopus Easy Mode Otimiza Rollouts Progressivos com Validação Automática" mostrou uma release passando por ambientes em sequência, com portões de validação. A notícia atual junta as duas pontas: o problema de escala e a promoção em etapas como camada própria, acima do sync.
Por que isso importa
Para quem opera frotas grandes, a leitura é que acelerar o sync não resolve o risco. O que reduz o raio de impacto é ter ondas, critérios de passagem registrados e visibilidade de qual versão roda onde. Vale mapear o que ApplicationSets, Fleet ou OCM já entregam antes de construir algo por conta própria.
Linha do tempo
CEVIU noticia os limites de escalar GitOps de 20 a 50 clusters e a gestão de frotas.
CEVIU noticia rollouts progressivos com validação automática no Octopus Easy Mode.
Jesse Suen, da Akuity, defende promoção em etapas para frotas com mais de 200 clusters.
Perguntas frequentes
Por que o GitOps fica mais difícil quando a frota cresce?
Com centenas de clusters, um único merge pode disparar mudança em toda a produção. Sem promoção em etapas e gates de validação, uma release defeituosa se espalha antes de o problema ser detectado e contido.
Qual a diferença entre sincronização GitOps e promoção de release?
A sincronização alinha o estado dos clusters ao desejado no Git. A promoção adiciona avanço controlado entre grupos de clusters, usando resultados de verificação e critérios de aprovação para decidir quando a release segue.
Ferramentas como ApplicationSets e Rancher Fleet já resolvem isso?
Em parte. ApplicationSet Progressive Syncs, rollout partitions do Fleet e as estratégias do OCM fazem ondas e pausam com clusters não saudáveis. Segundo Suen, ainda falta rastrear a release, reter o histórico de verificação e definir o próximo destino.
Como começar a melhorar o deploy em centenas de clusters?
Organize os clusters em ondas e escolha um grupo pequeno para receber primeiro. Defina o que precisa passar antes da próxima onda e teste se uma verificação com falha realmente interrompe a propagação.
Fontes
- cloudnativenow.comfonte original
- Categoria
- CEVIU DevOps
- Publicado
- 23 de outubro de 2026
- Editoria
- CEVIU DevOps